 Нейродвиж от Алекса
Qwen 3.8 27B умеет читать веса моделей
· 1 мин чтения
Три модели для картинок на своём компьютере: как мы их ставили и сравнивали, где они ошибаются, почему так выходит и что мы с этим делали. С примерами генераций.
15 мин чтенияРедакция «Нейродвиж»
Модель для картинок можно скачать файлом и запускать на своей видеокарте, без облачного сервиса. Мы так и работаем: обложки для «Нейродвижа» делает модель, которая стоит у нас на компьютере. В статье — три модели, которые мы поставили, наши сравнения, ошибки моделей с примерами и поломки, на которые ушло больше всего времени.
Все люди на картинках придуманы моделью. Таких женщин не существует.
Облачная модель — это сайт или приложение: пишете запрос, картинку считает сервер компании. Локальная — это файл на вашем диске и программа, которая его запускает. Запрос и картинка остаются на вашем компьютере, за каждую генерацию никто не берёт плату.
Взамен нужны видеокарта и место на диске. Наш компьютер — с видеокартой RTX 4080 SUPER на 16 ГБ памяти и 64 ГБ оперативной памяти. Модели запускаем через ComfyUI: это бесплатная программа, где генерация собирается из блоков.
У каждой модели своя лицензия. В ней написано, можно ли использовать картинки в коммерческих проектах и в каких странах.
Эта часть объясняет почти все ошибки, которые будут ниже.
Запрос сначала режется на кусочки слов — токены. Отдельная программа, текстовый кодировщик, превращает их в набор чисел. Слов модель рисования не получает, она получает эти числа.
Картинка начинается с шума, похожего на рябь старого телевизора. Какой именно будет шум, задаёт одно число — зерно генерации (seed). Дальше модель за несколько шагов убирает шум и на каждом шаге сверяется с числами запроса. Быстрым моделям хватает 4–6 шагов, полным нужно 30 и больше.
Рисует модель в сжатом виде. Картинка для неё — сетка ячеек, и одна ячейка описывает целый квадратик пикселей. В конце отдельная часть модели разворачивает сетку в обычное изображение. Поэтому на мелкие детали приходится мало ячеек: лицу размером 240 пикселей или маленькой вывеске просто не хватает места.
Модель училась на огромном числе картинок с подписями. Она запомнила, как обычно выглядит то, что описано такими словами. Она не строит сцену в трёх измерениях, не считает отражение в зеркале и не знает букв: буквы для неё — такие же формы, как листья или кирпичи. И она ничего не помнит между запусками. Каждая картинка делается с нуля из нового шума.
FLUX.2 klein-4B. Лицензия Apache-2.0: можно использовать в коммерческих проектах. Файл модели — 7,2 ГБ, вместе с текстовым кодировщиком она целиком помещается в 16 ГБ памяти видеокарты. Картинку делает за 4 шага. Самая быстрая из трёх: 3,1 секунды на картинку 1024×1024, когда модель уже загружена, и 7,7 секунды на первую картинку после запуска.
Qwen-Image-2512 Lightning. Тоже Apache-2.0 и тоже 4 шага. Файл модели — 20,4 ГБ, текстовый кодировщик — ещё 8,7 ГБ. В 16 ГБ это не помещается. ComfyUI держит часть модели в оперативной памяти и подгружает в видеокарту по мере надобности; на это уходит около 20 ГБ оперативной памяти. Скорость при этом остаётся рабочей: 5,4 секунды на картинку 1024×1024 и 9,9 секунды на первую. У той же команды есть модель для правки готовых картинок, Qwen-Image-Edit: одна правка занимает 9,9 секунды.
MiniMax H3-Image. Вышла 10 ноября 2026, мы поставили её 13 ноября. Файлы большие: 21 ГБ модель и 27 ГБ текстовый кодировщик. Картинку делает за 6 шагов. Запрос ей нужен один, длинный и подробный, на английском; списка «чего не рисовать» у неё нет. Размер картинки — от 4 до 20 мегапикселей; 16 мегапикселей на нашей карте она считает за 93 секунды. К запросу можно приложить до 16 картинок-образцов. Лицензия у неё своя, не Apache: она исключает ЕС, Великобританию, Корею и США.
В начале ноября, ещё до выхода H3-Image, мы сравнили klein и Qwen на 19 рабочих заданиях и трёх правках готовых картинок. Оценивали по списку признаков. По списку klein выиграла 11 заданий, Qwen — 5, ещё 6 вышли вничью.
Потом мы положили картинки рядом, и картинки Qwen оказались заметно лучше. Она точнее следует запросу. Вот задание «плоская иконка в два цвета: скрещённые кирка и лопата».
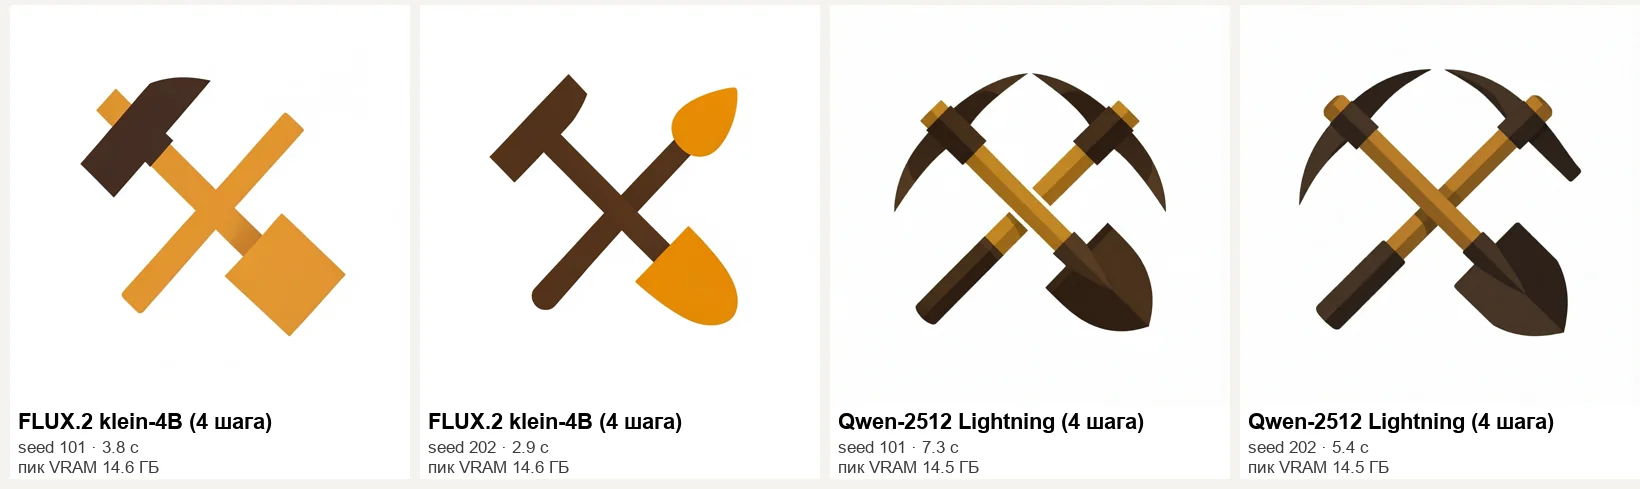
С 8 ноября Qwen у нас основная модель, klein осталась для быстрых черновиков. Новые модели мы теперь оцениваем, только посмотрев на картинки.
Что ещё показало то сравнение:
Для этой статьи мы дали всем трём моделям три задания с одним и тем же зерном. Qwen и klein рисовали в размере 1664×928: Qwen тратила на картинку около 8 секунд, klein — около 3. H3-Image рисовала в 2688×1504 и тратила 12 секунд; здесь её картинки уменьшены до размера остальных.
Лиса на снегу в берёзовом лесу на рассвете, фотография
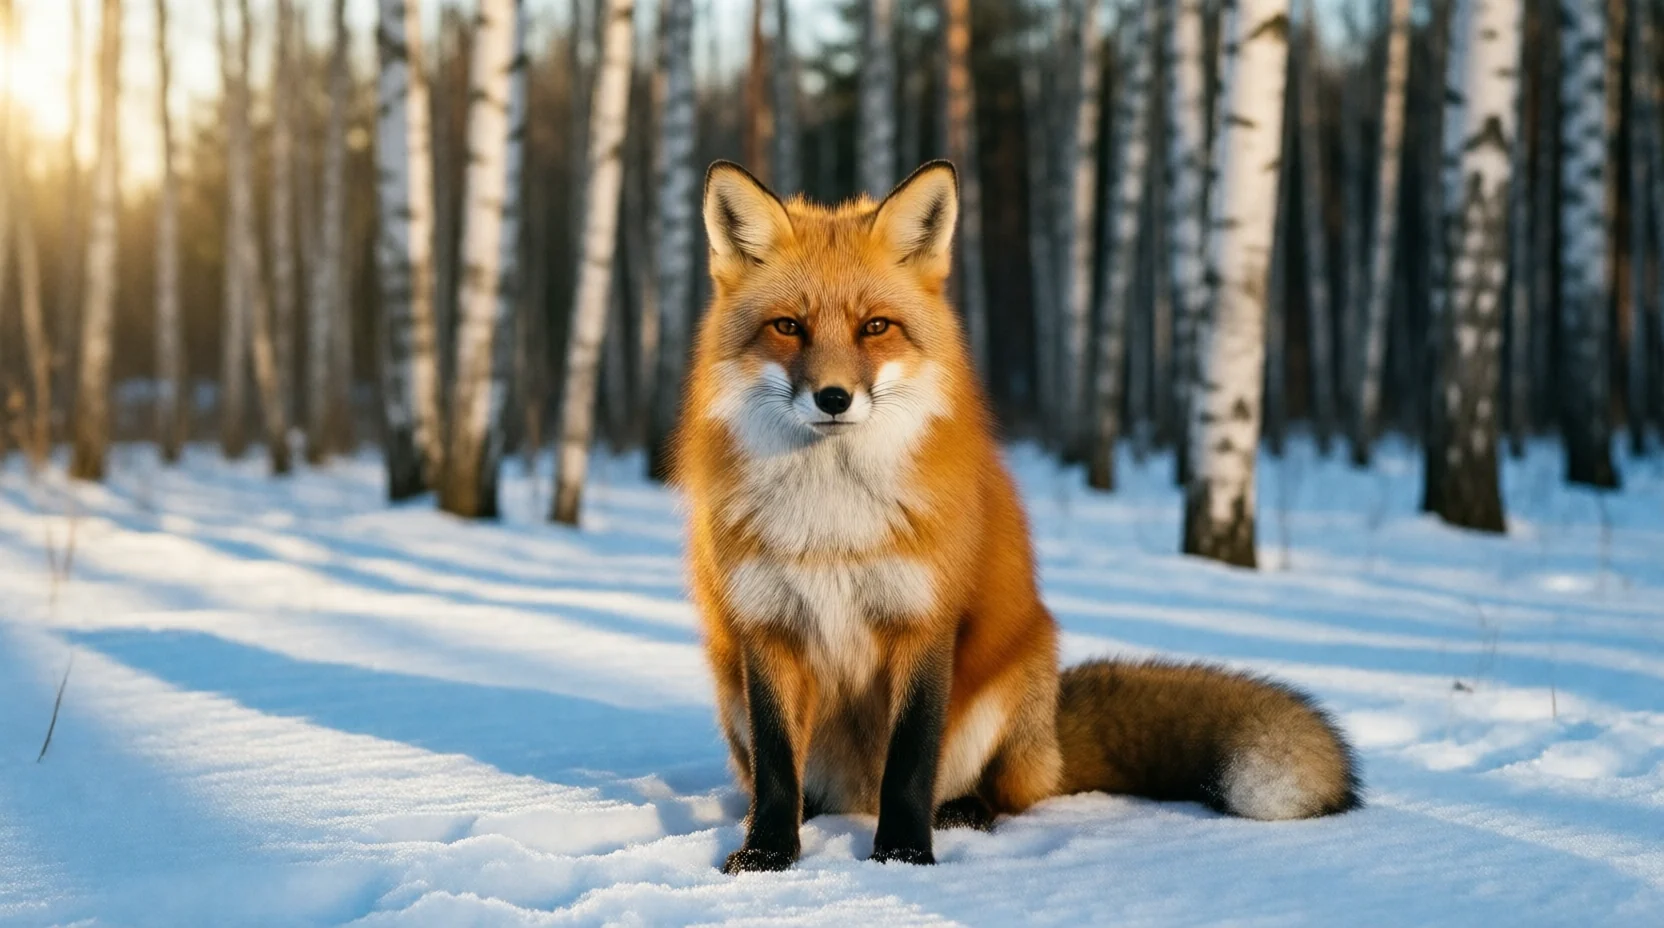
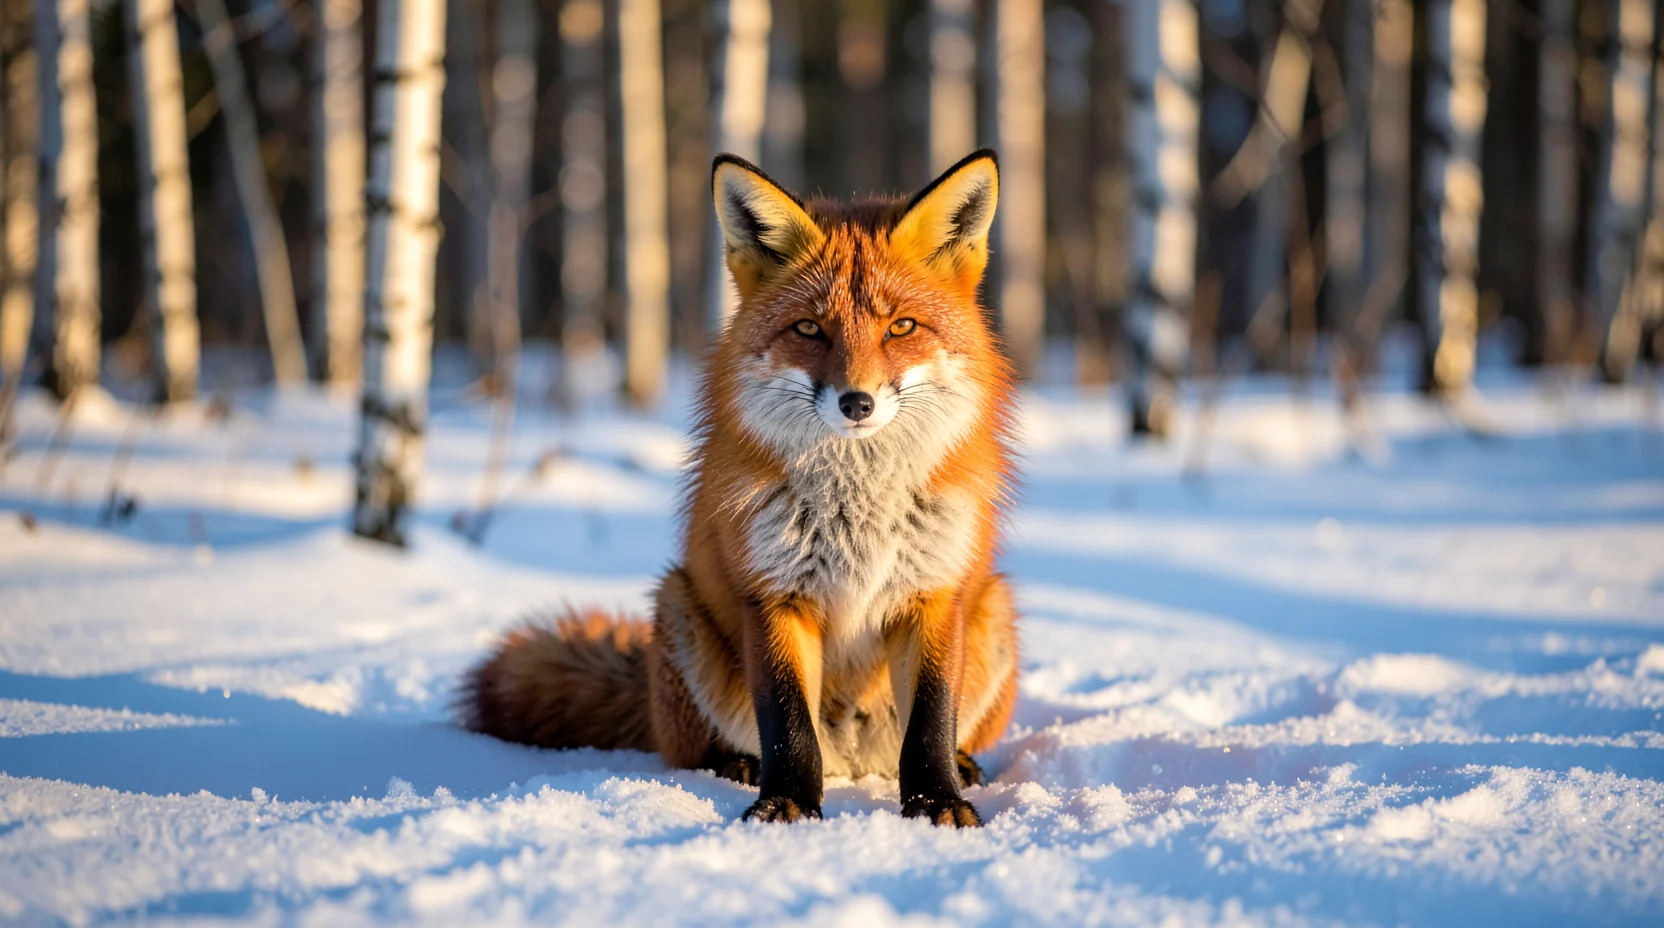
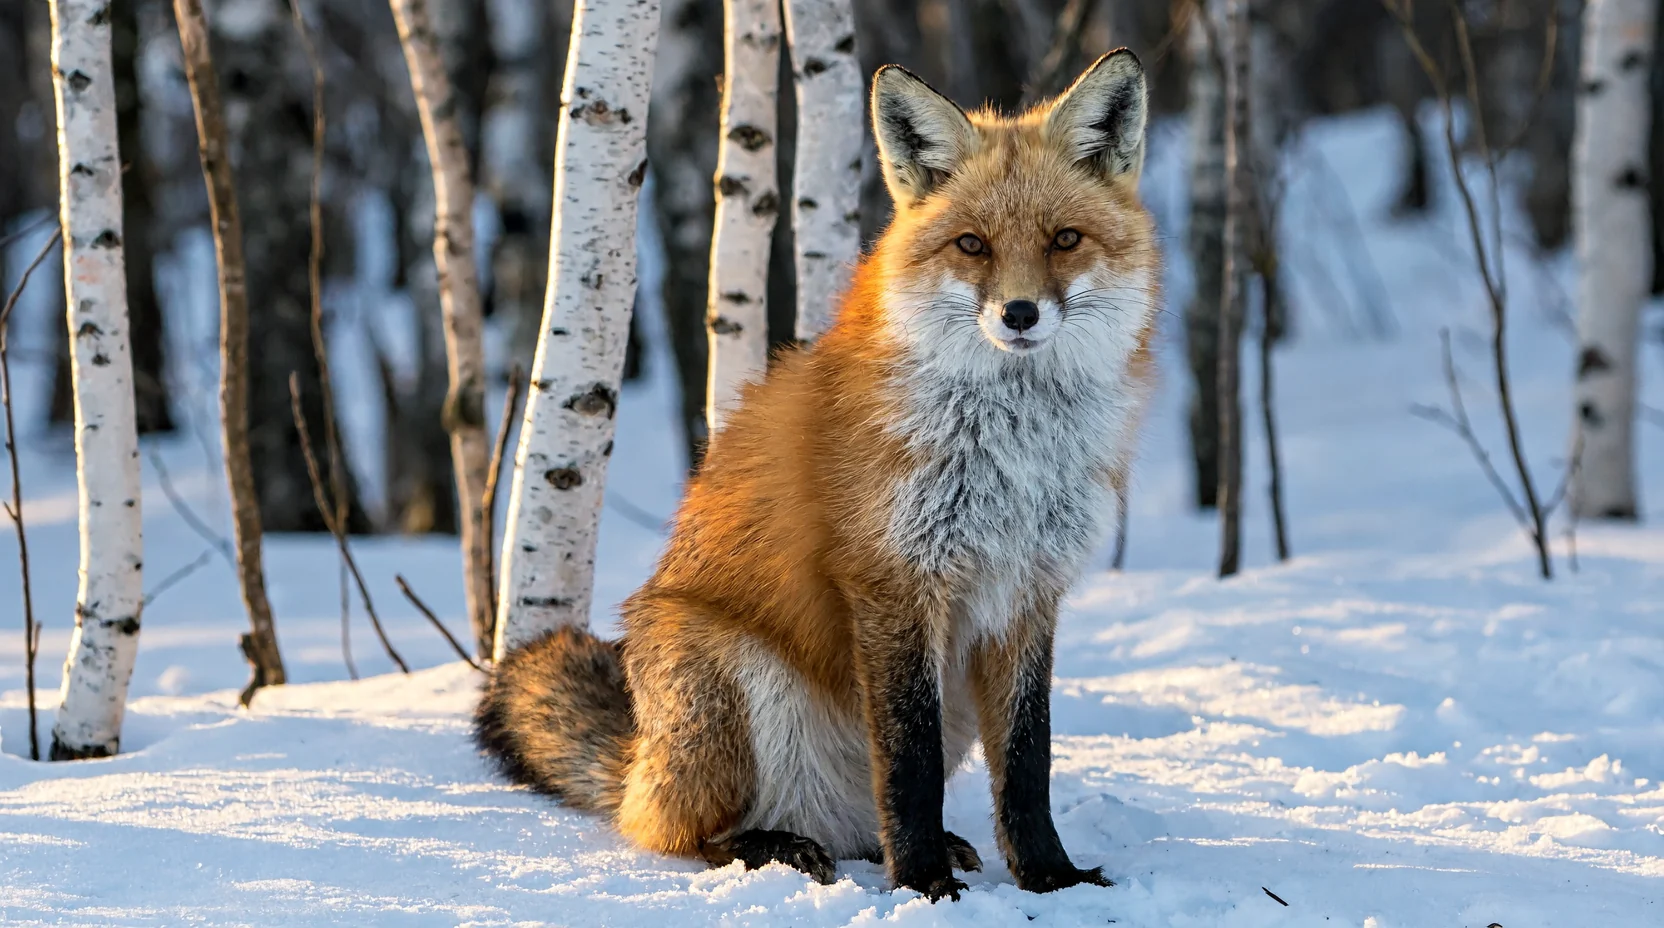
Все три справились. У Qwen низкое солнце светит слева. У H3-Image лиса сидит правее центра, грудь у неё серее.
Меловая доска у кафе с тремя строчками текста и рисунком чашки
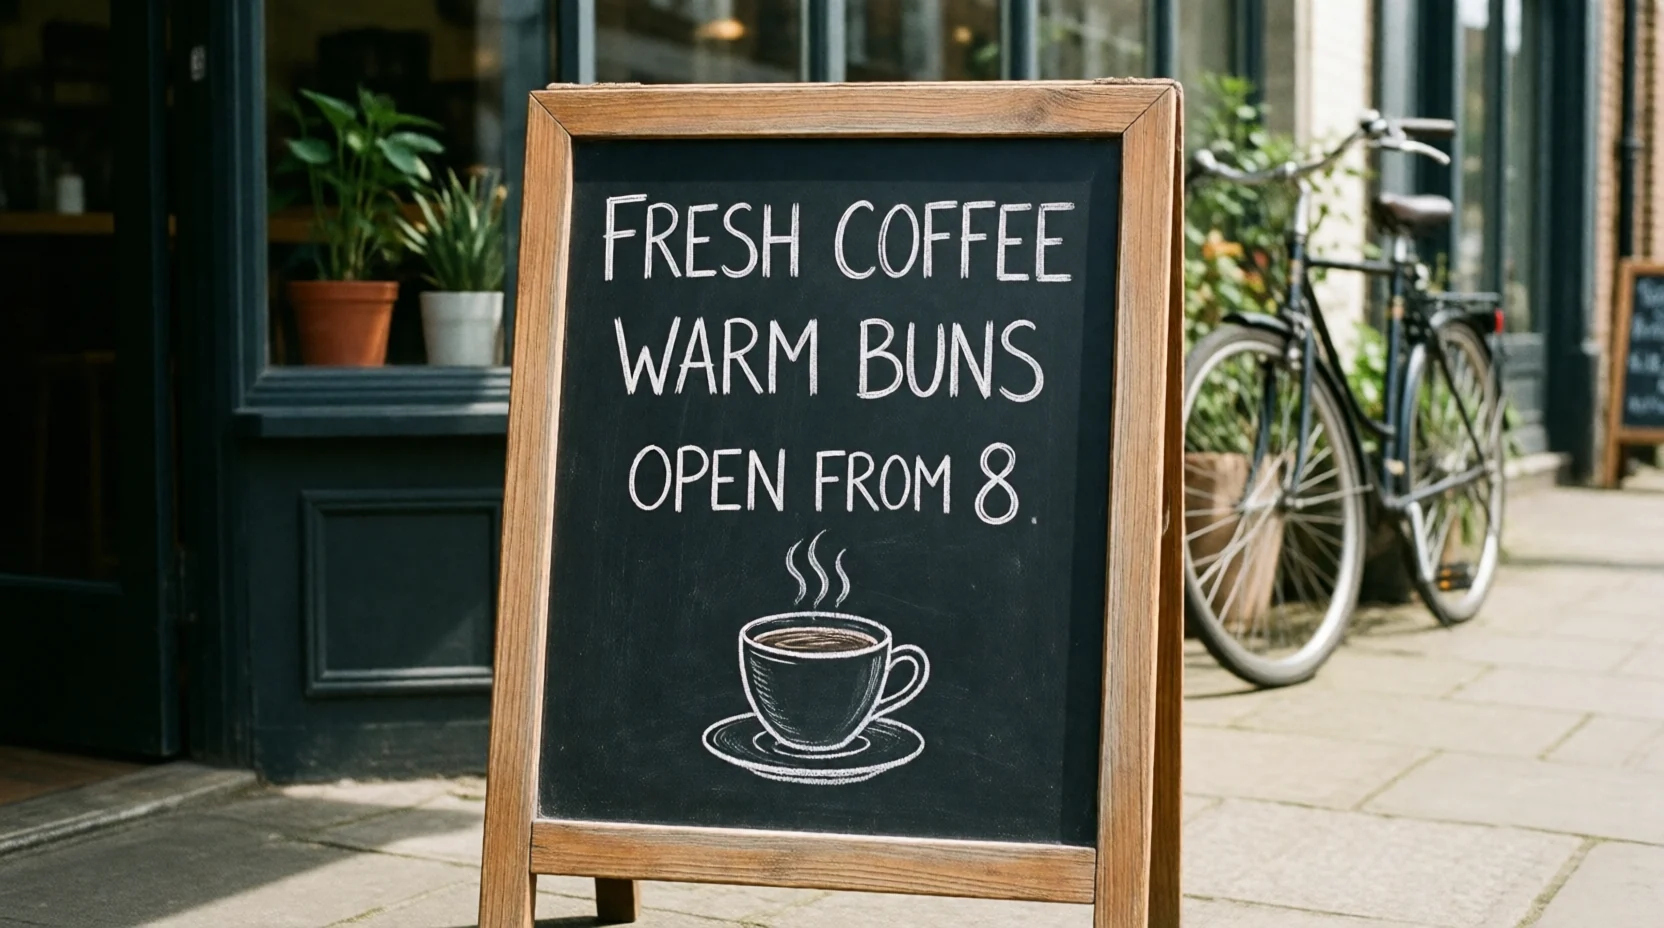
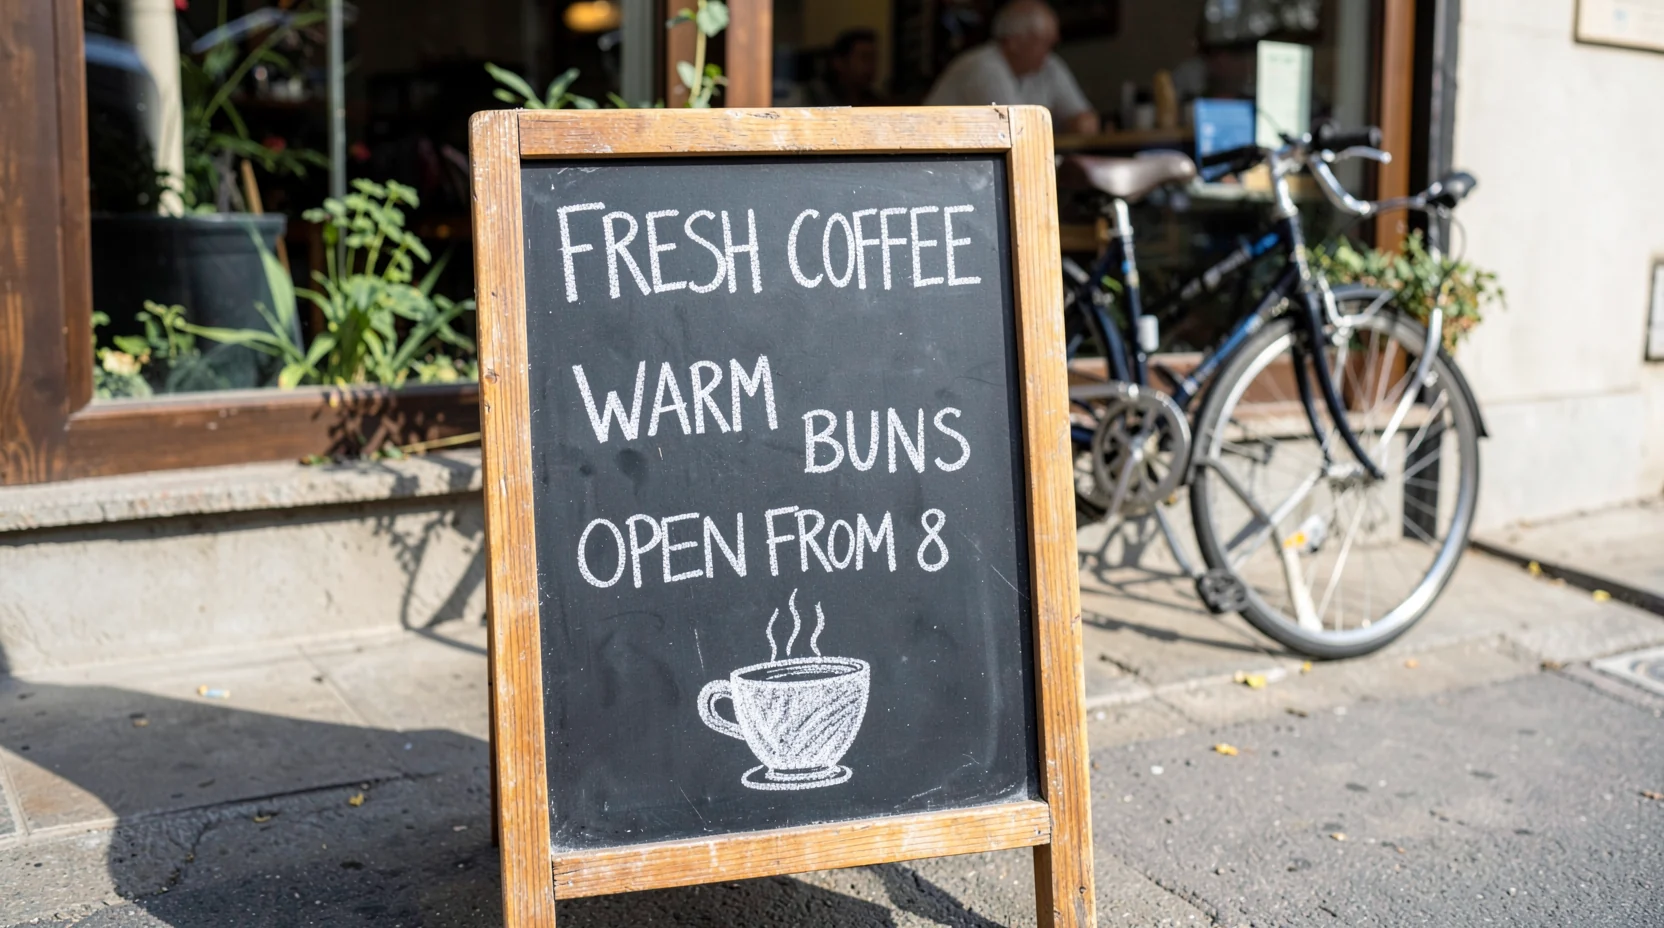
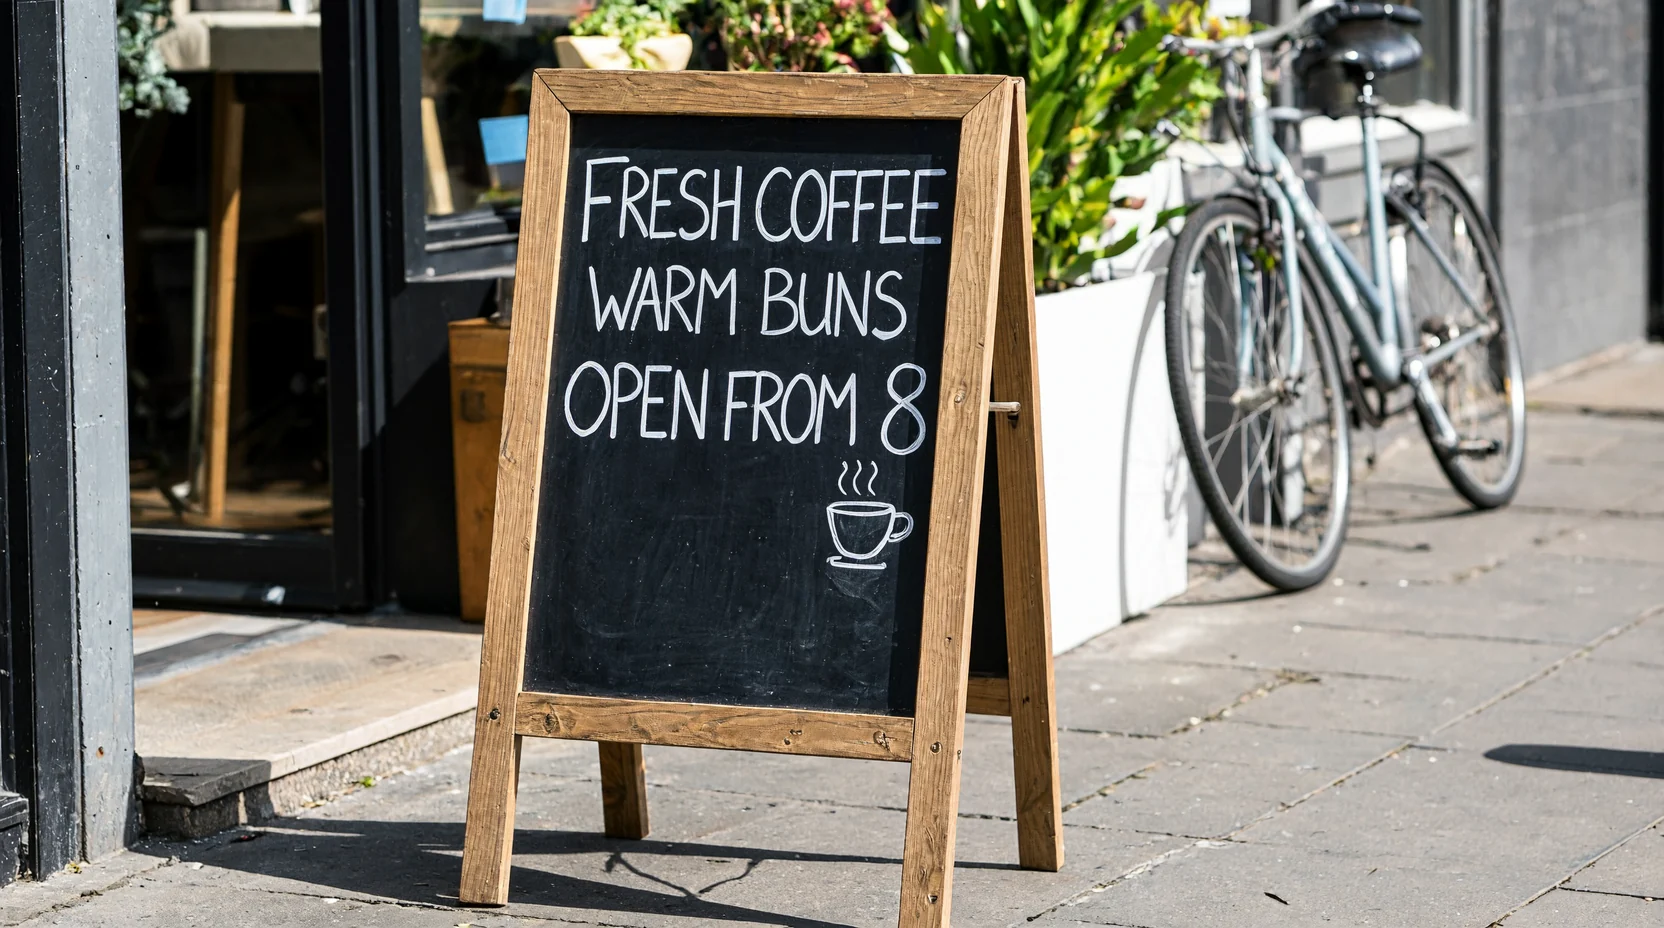
Все три написали все три строчки без ошибок: FRESH COFFEE, WARM BUNS, OPEN FROM 8. У klein в окне кафе появился размытый человек, которого мы не просили.
Игровой сундук с монетами в стиле low-poly на белом фоне
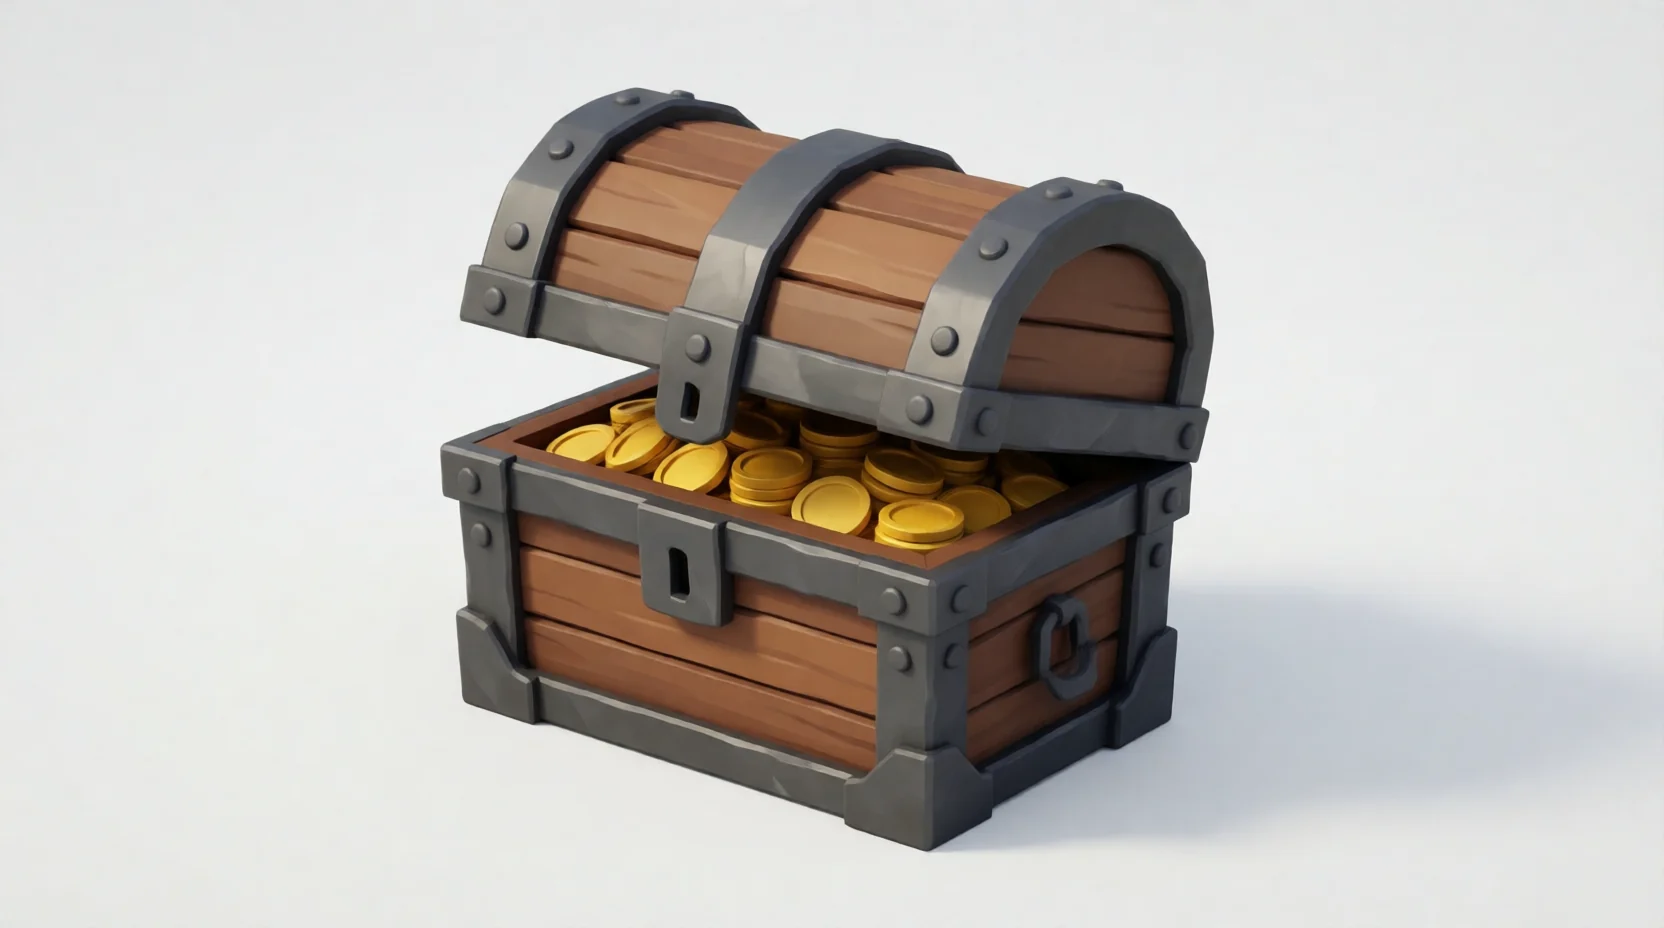
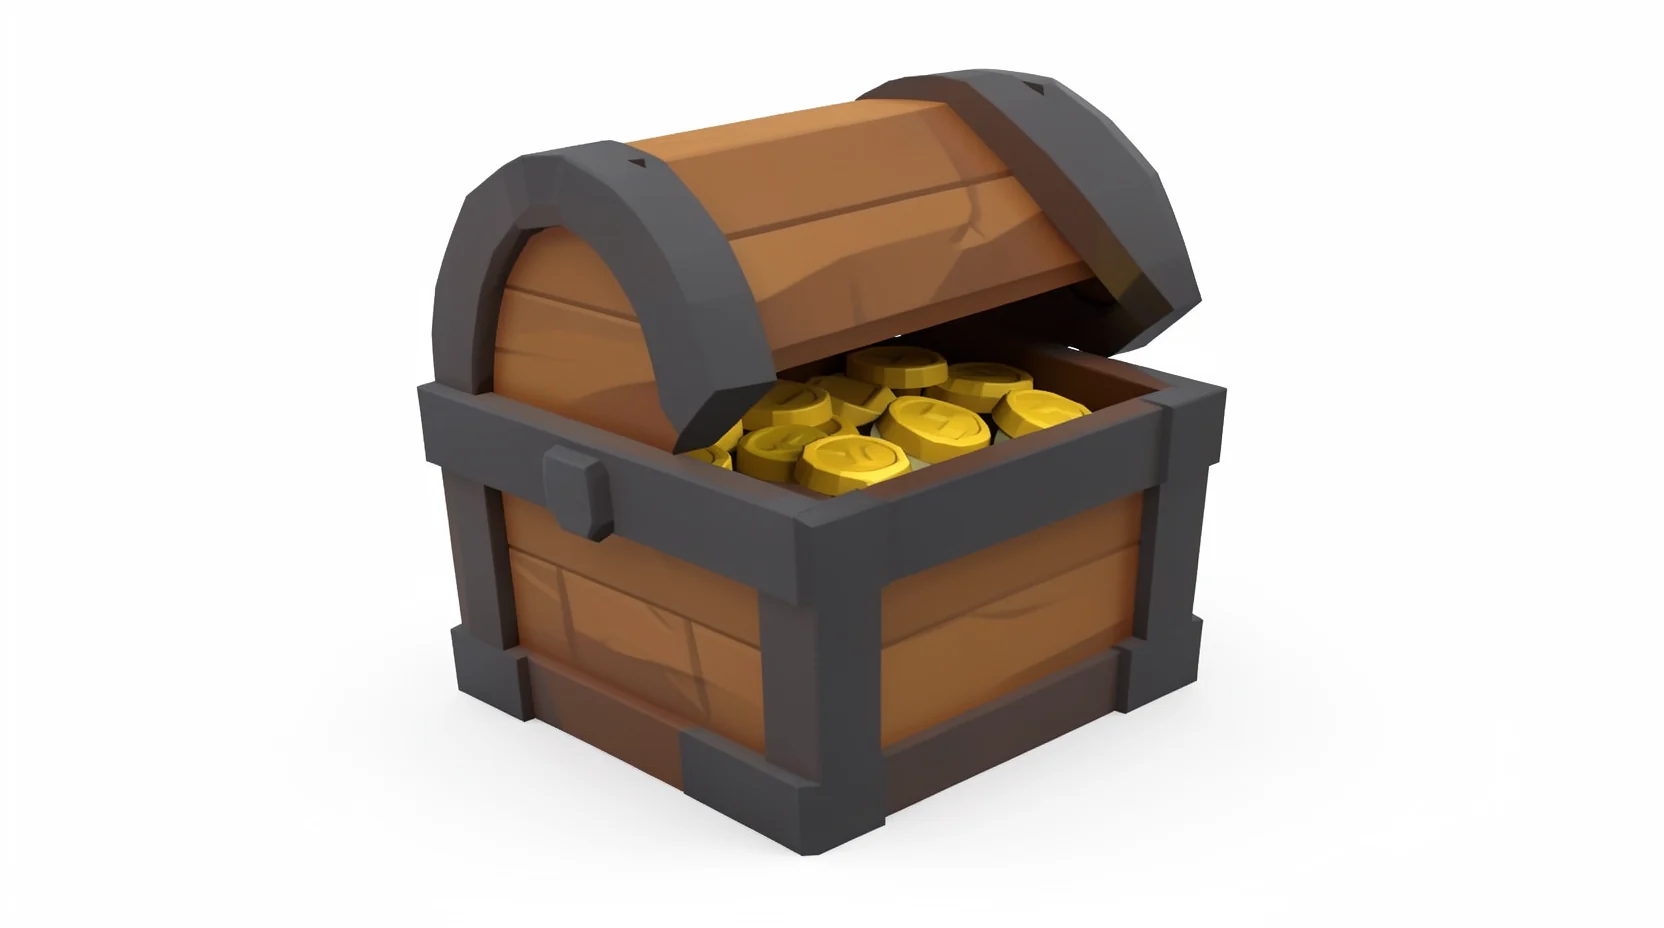
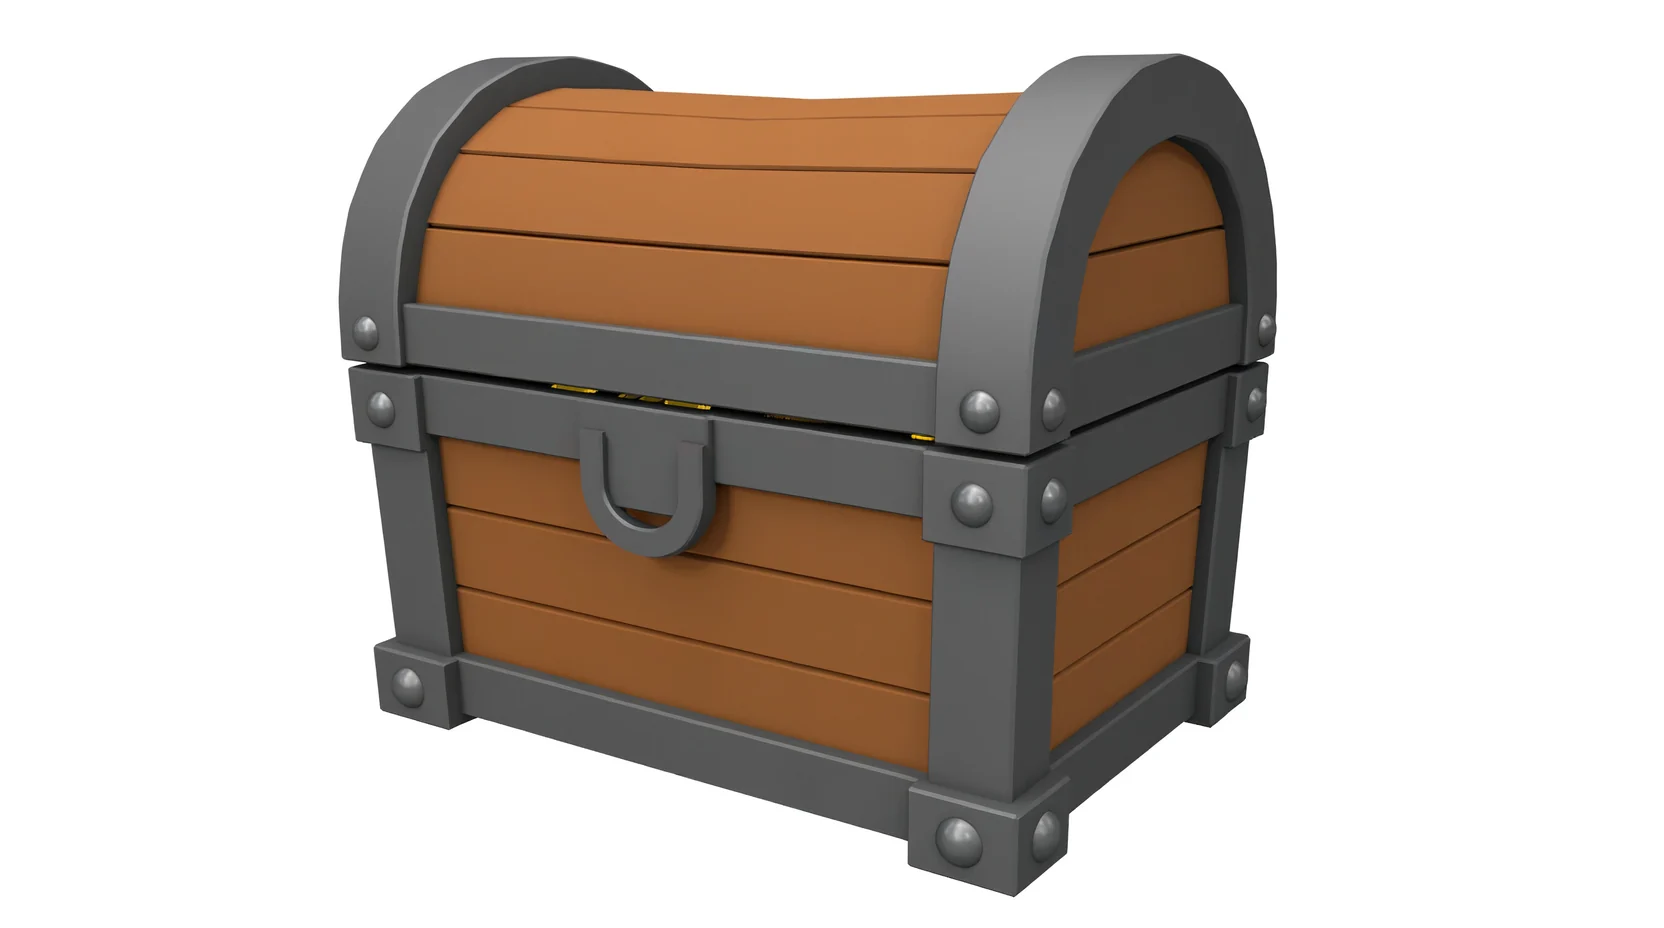
Qwen и klein нарисовали открытый сундук с монетами. У klein фон чисто белый, у Qwen — светло-серый, с тенью под сундуком. У H3-Image сундук закрыт, монет не видно, а формы гладкие, не low-poly.
Мы описали одну женщину и дали это описание всем трём моделям: 27 лет, длинные волнистые каштановые волосы, серо-зелёные глаза, немного веснушек на носу, спокойный внимательный взгляд. Первый кадр — студийный портрет.
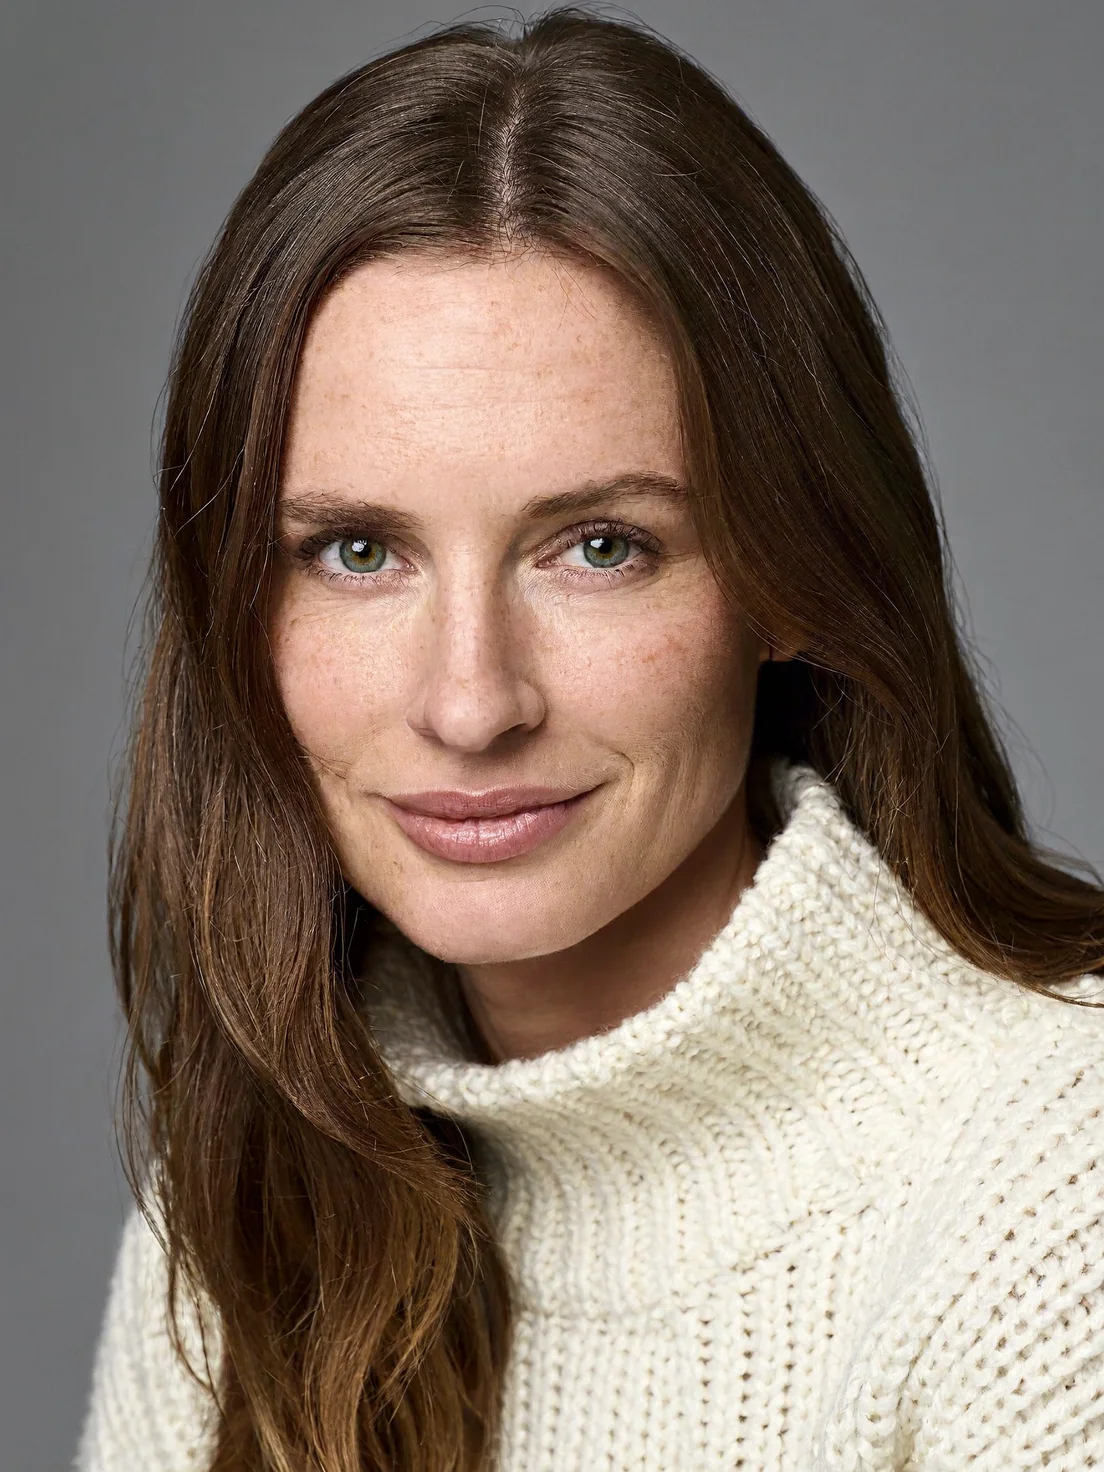
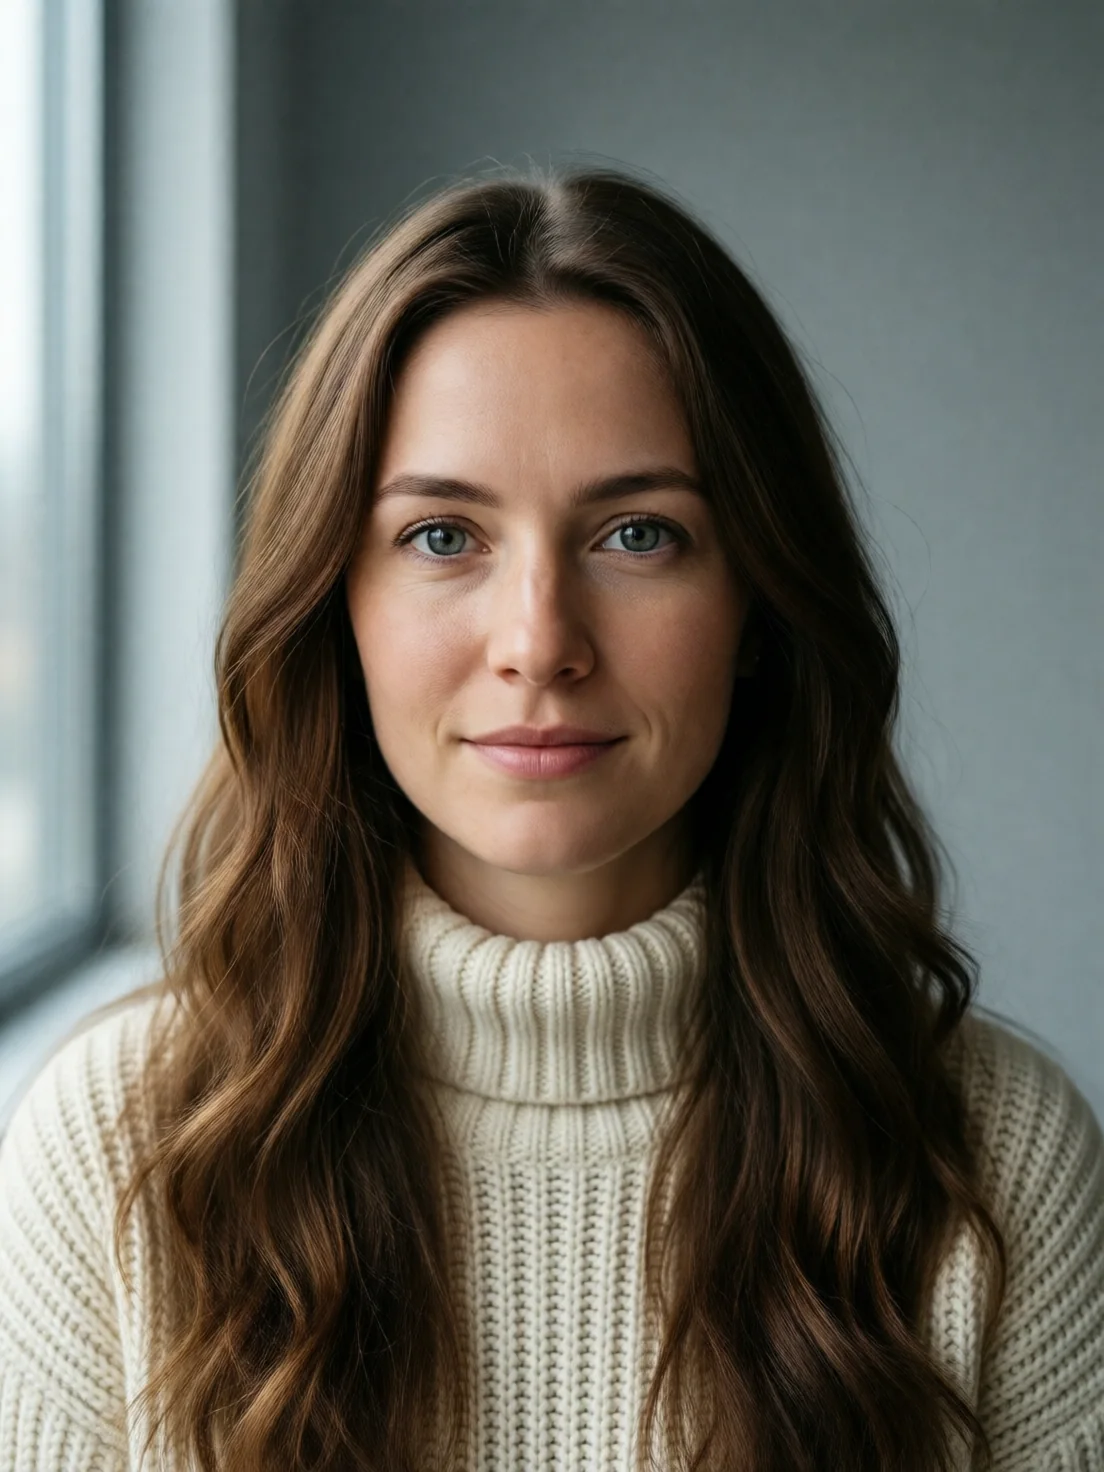
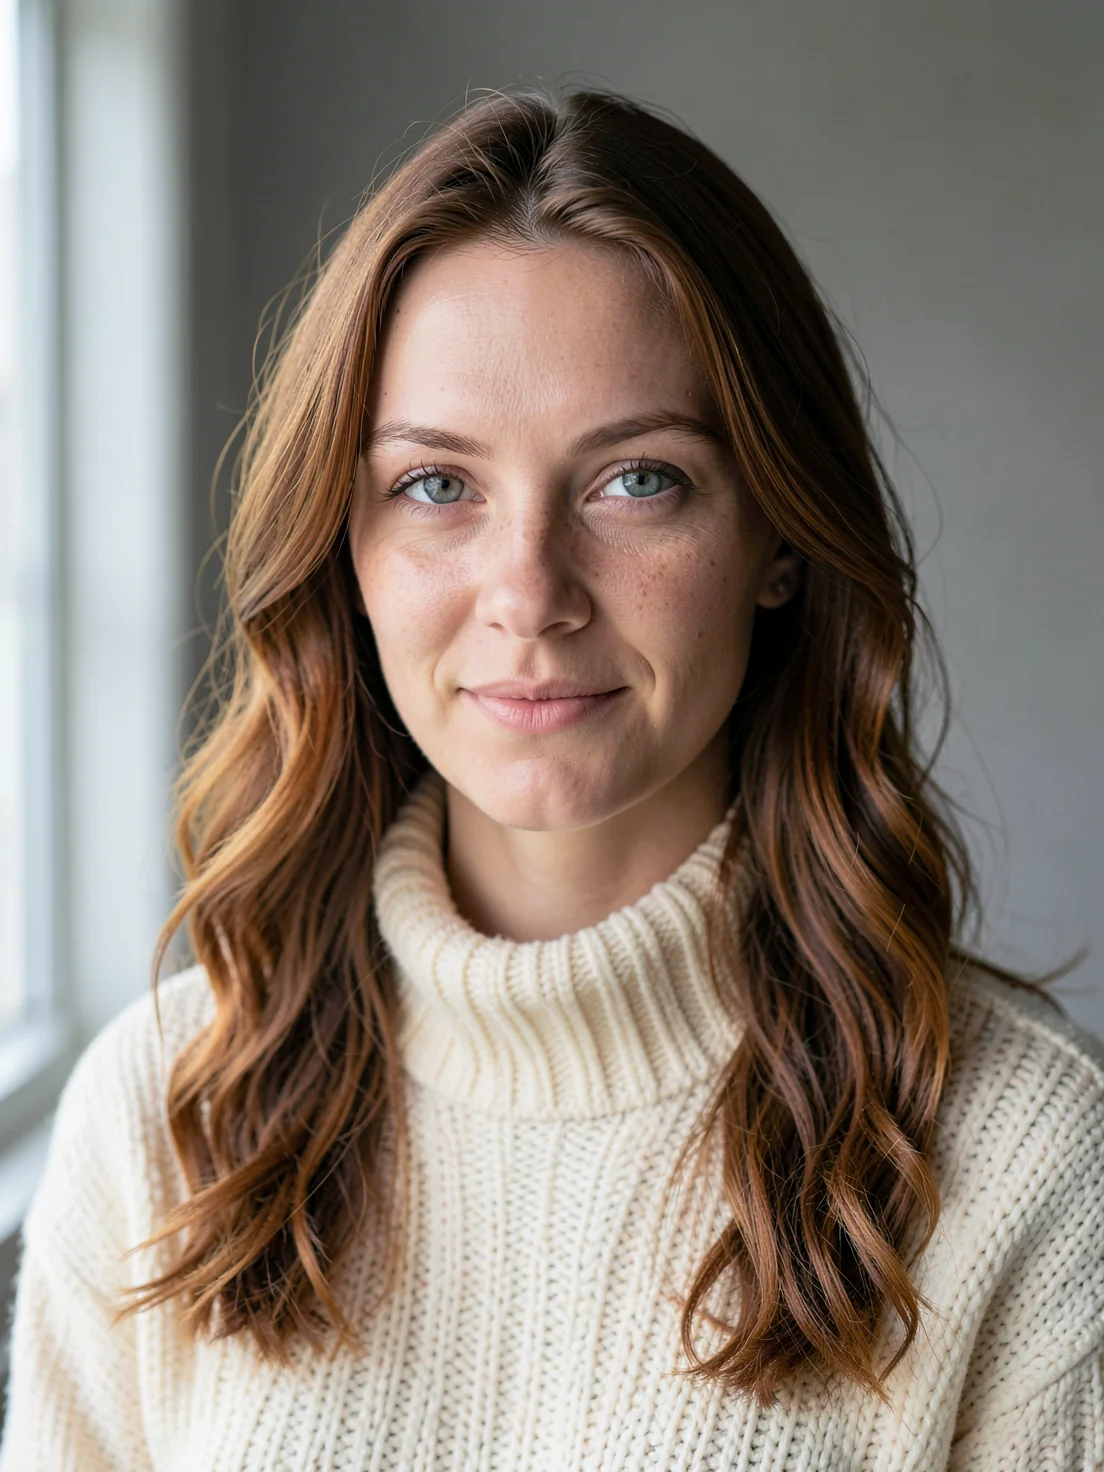
Три модели нарисовали трёх разных женщин. У Qwen и klein они выглядят на заявленные 27 лет. У H3-Image женщина выглядит лет на 35–40, хотя возраст в запросе тот же. Зато кожа, волосы и ткань у H3-Image больше всего похожи на фотографию. Почему она прибавляет возраст, мы не выясняли.
Второй кадр — та же женщина по описанию, но в кафе у окна.
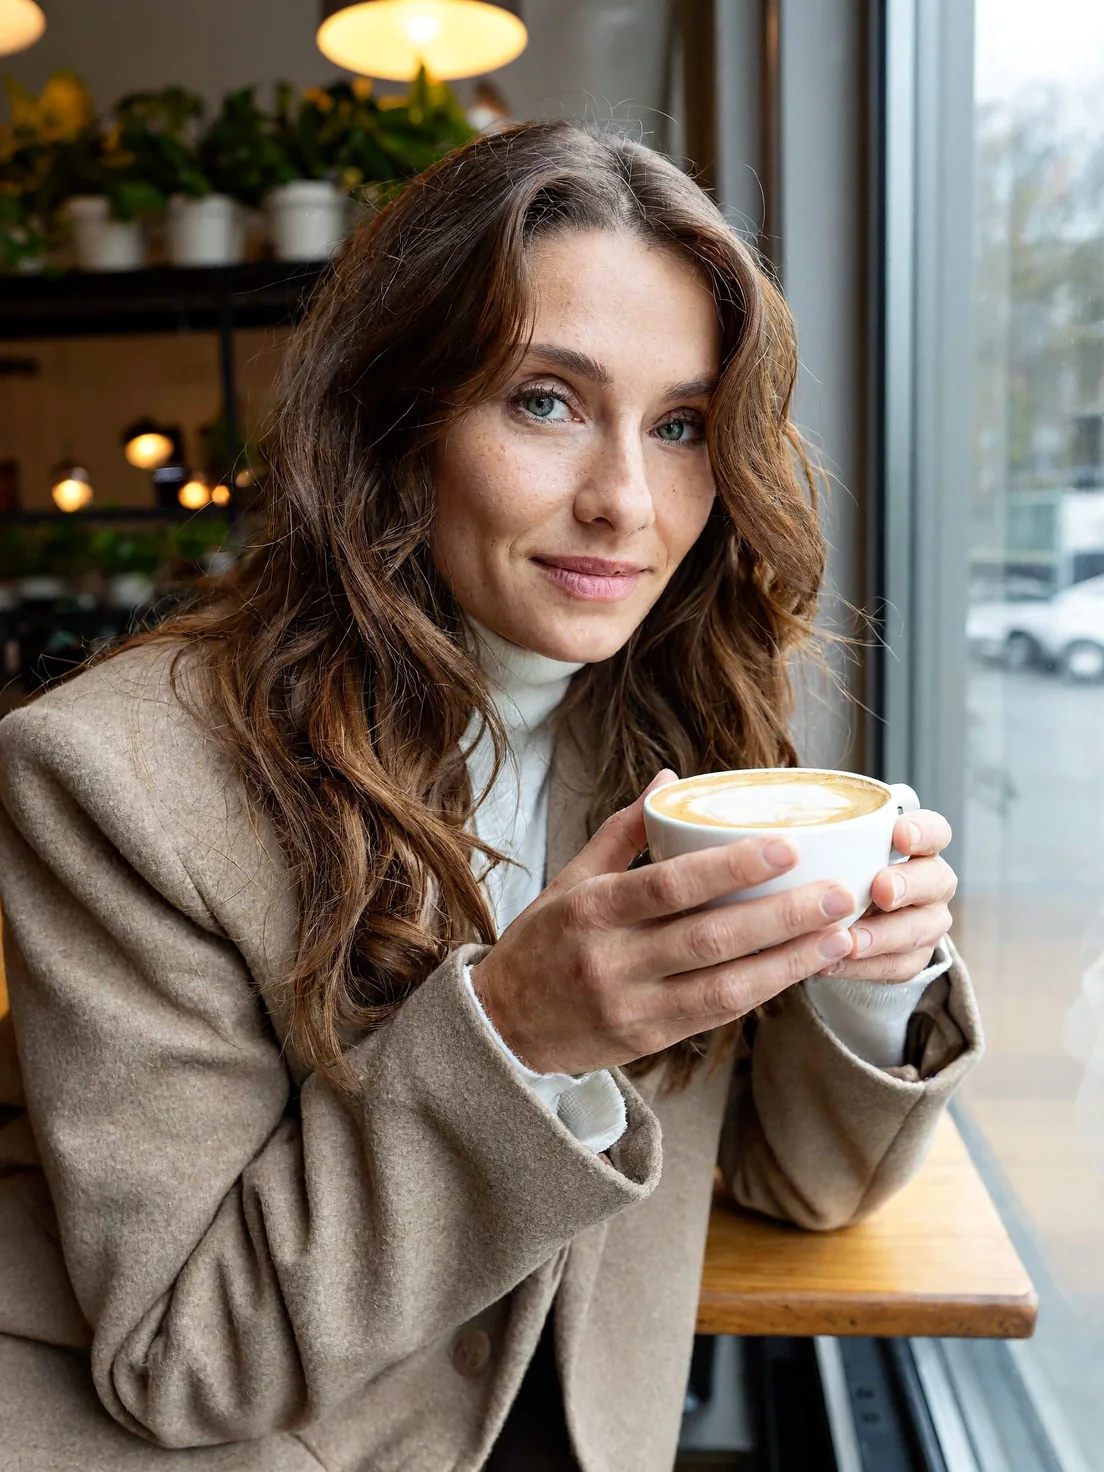
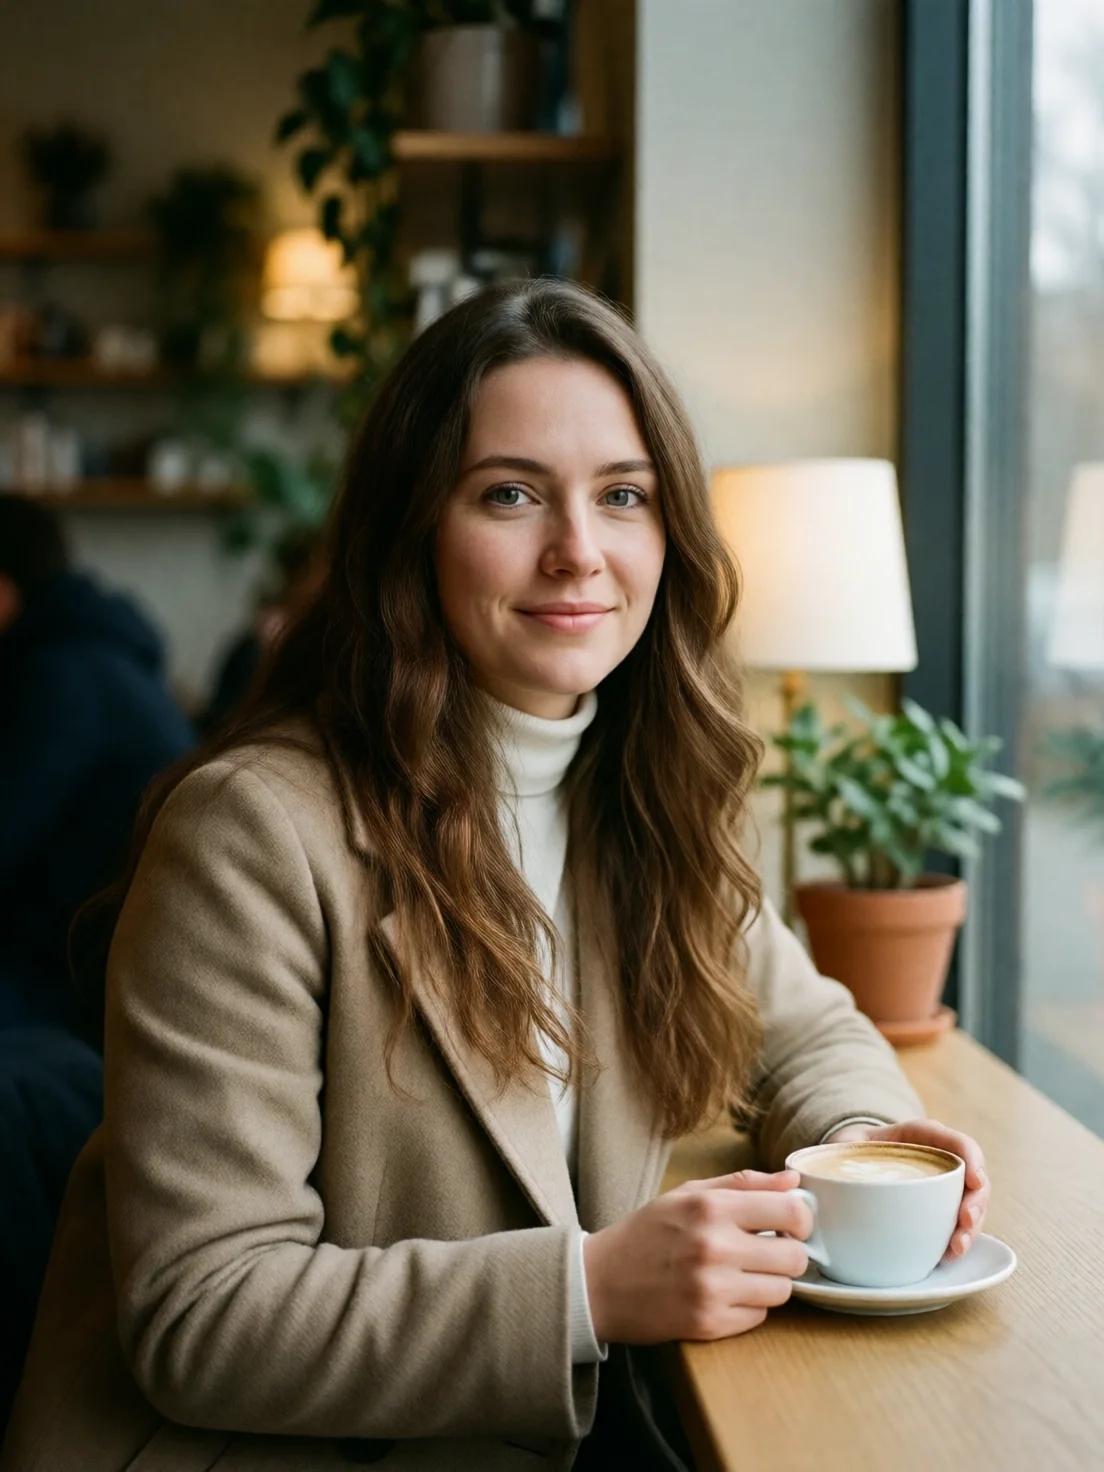
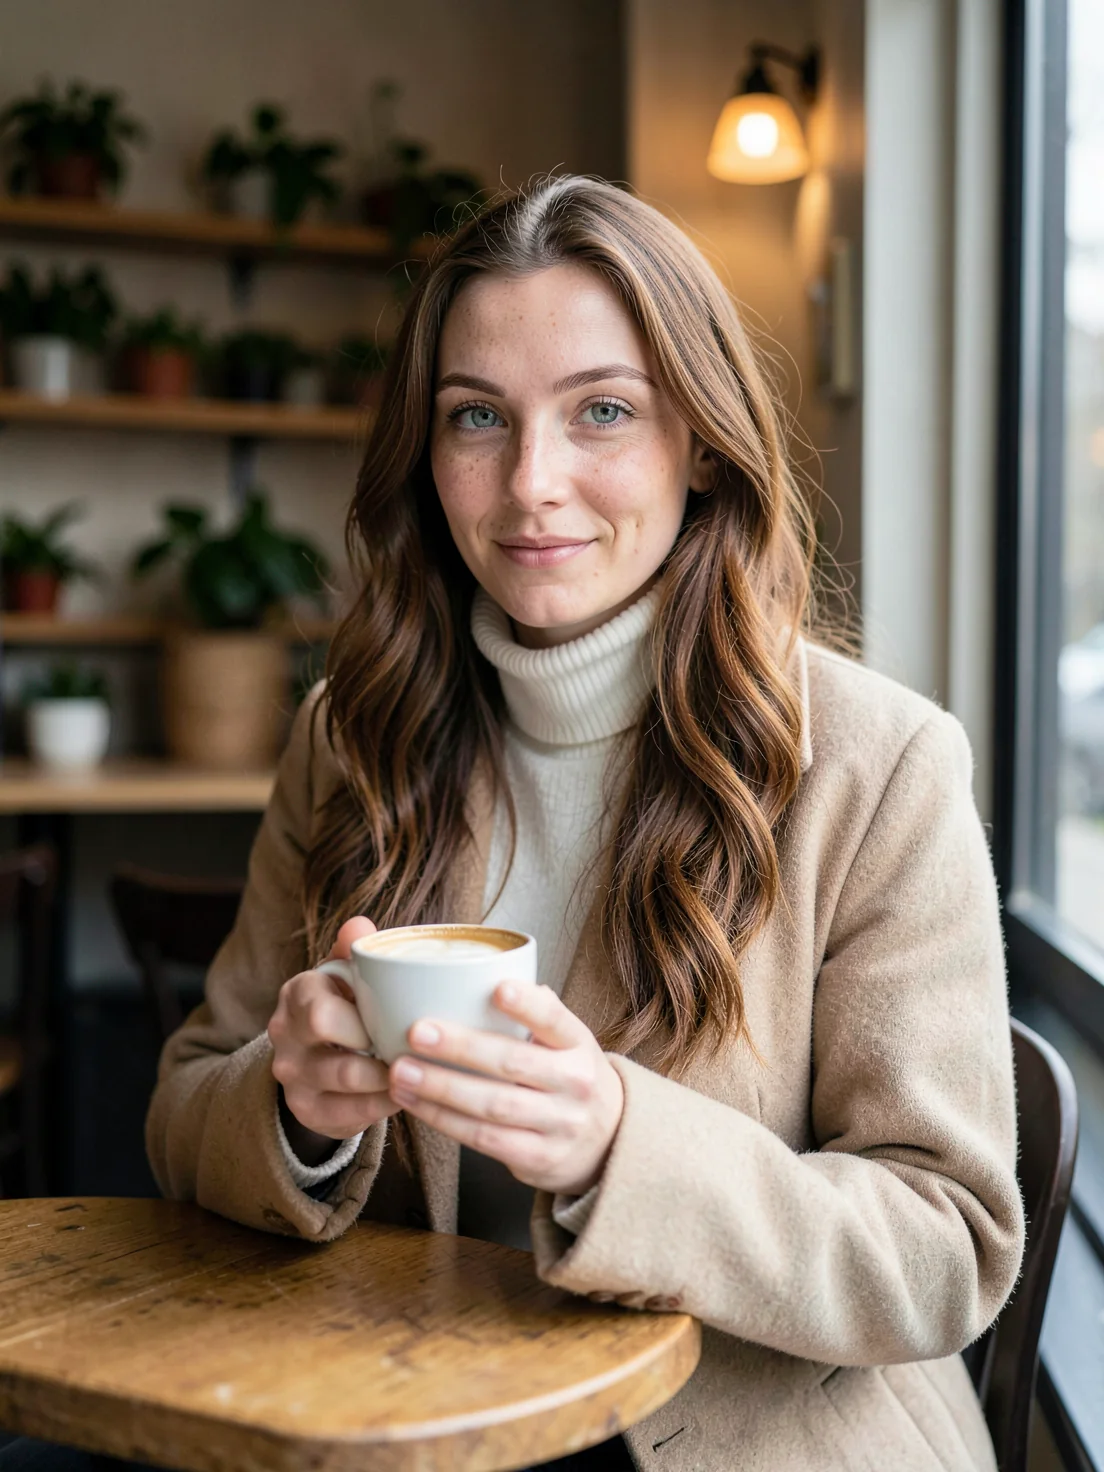
Описание женщины слово в слово то же, а у каждой модели в кафе сидит уже другой человек, непохожий на её же студийный портрет.
H3-Image рисовала портреты в размере 1728×2304 и тратила на каждый около 12 секунд. Qwen рисовала в 1104×1472: 14,8 секунды на первый кадр и 8,3 на следующий. klein — 6,7 и 3,3 секунды.
Дальше все примеры сделаны на H3-Image.
Мы трижды запустили студийный портрет с одним и тем же текстом и поменяли только зерно: 7, 8 и 9.
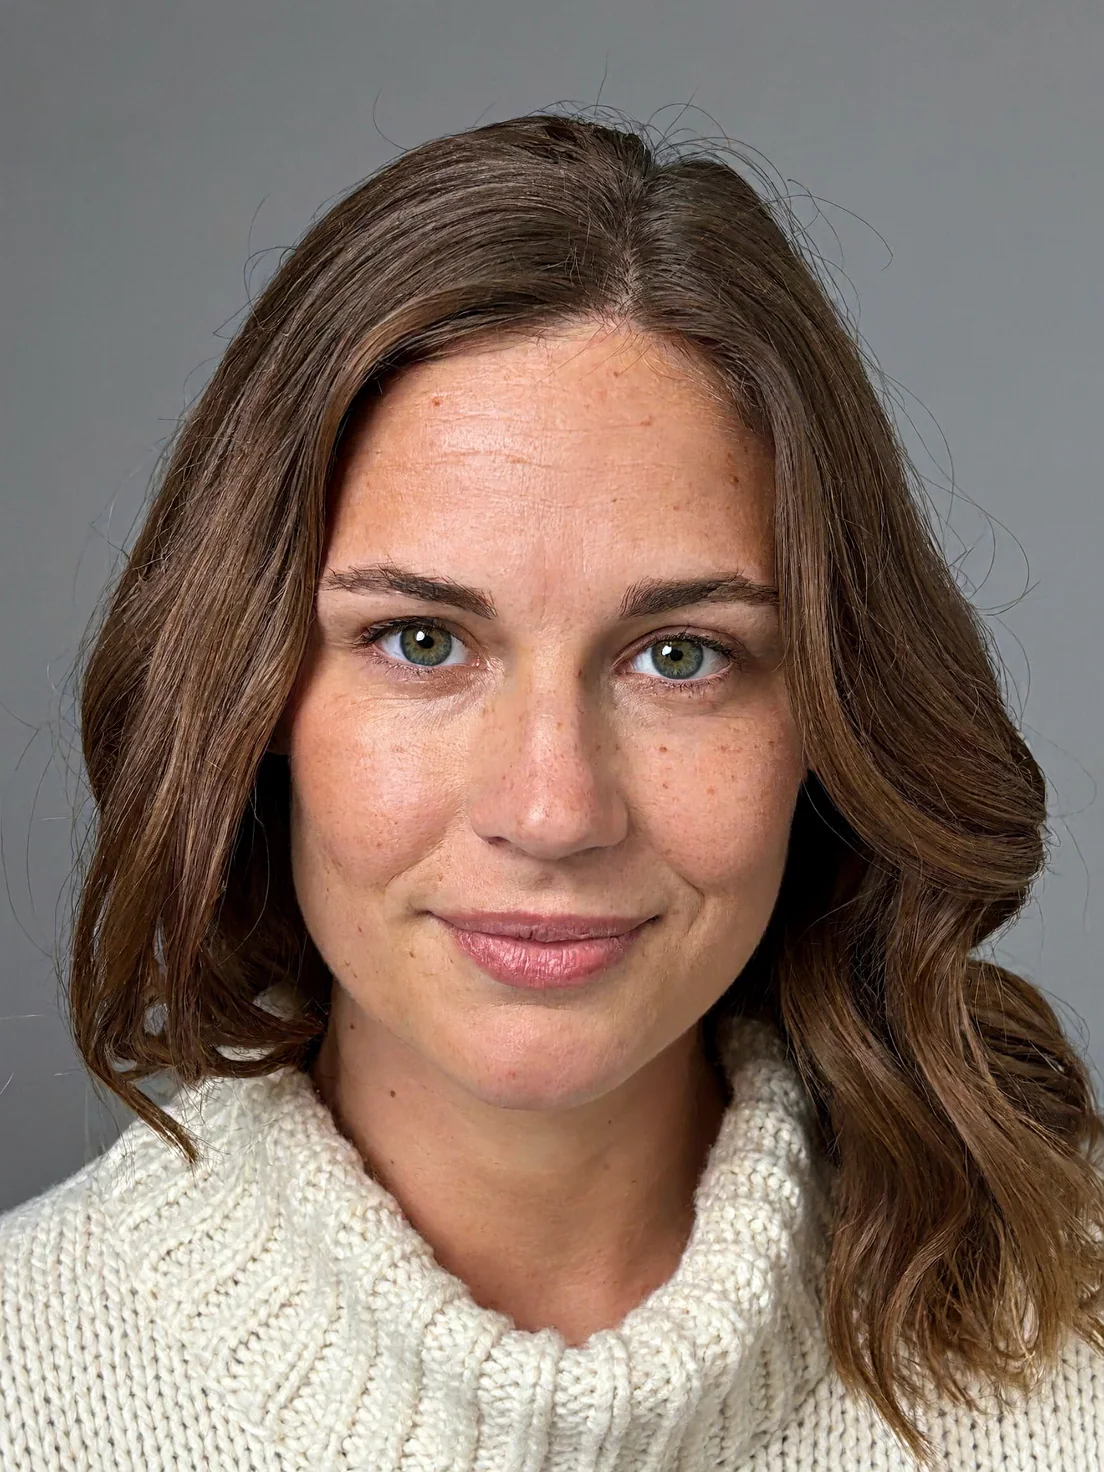
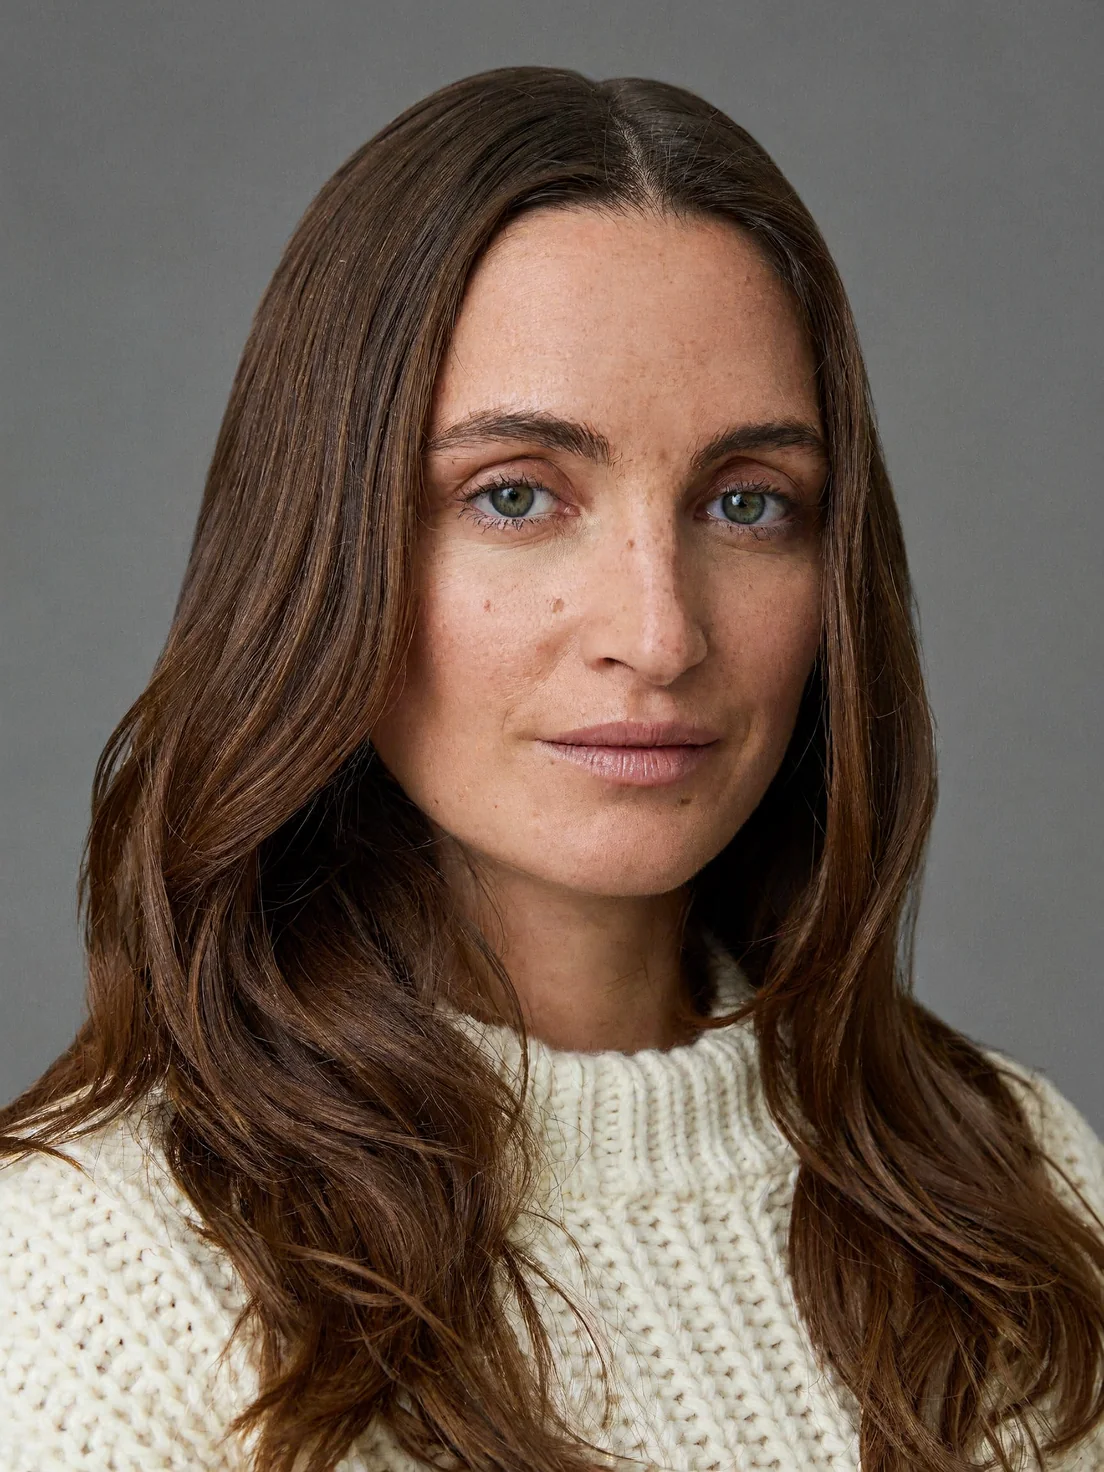
Получились три разные женщины. Под слова «каштановые волосы, серо-зелёные глаза, веснушки» подходят миллионы лиц. Какое из них выйдет, решает начальный шум. Одно и то же зерно с тем же текстом даёт ту же картинку, но стоит поменять в тексте сцену — и лицо снова другое.
Два портрета с одним зерном. Отличается одна фраза о чертах лица.
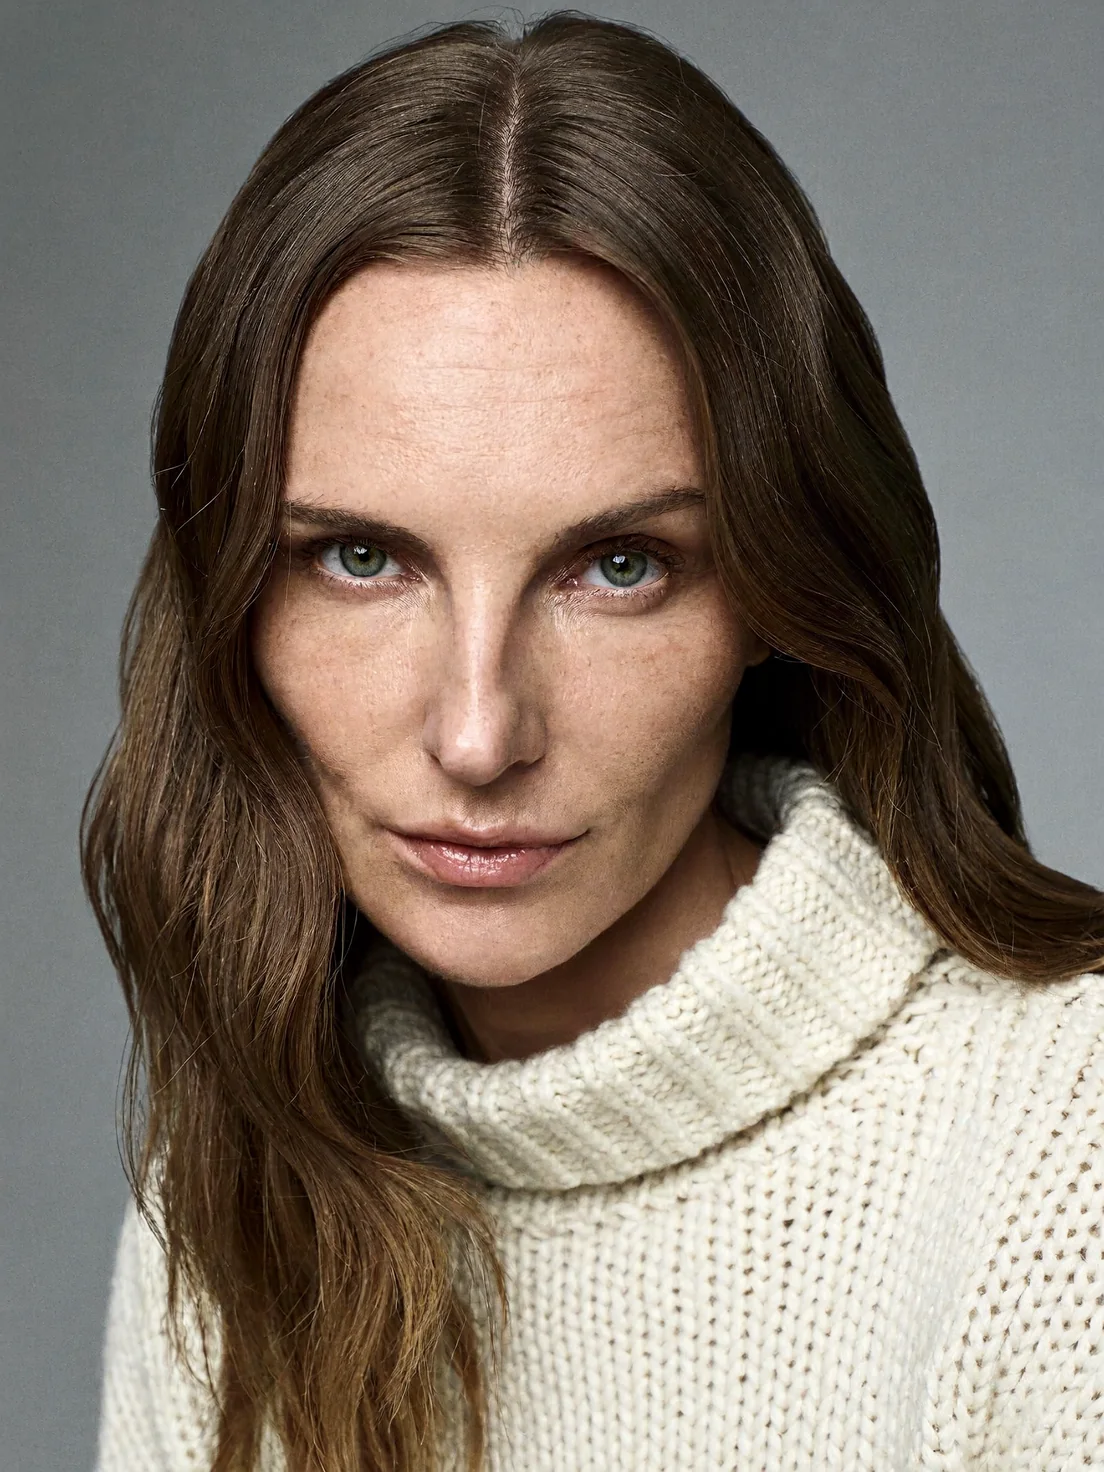
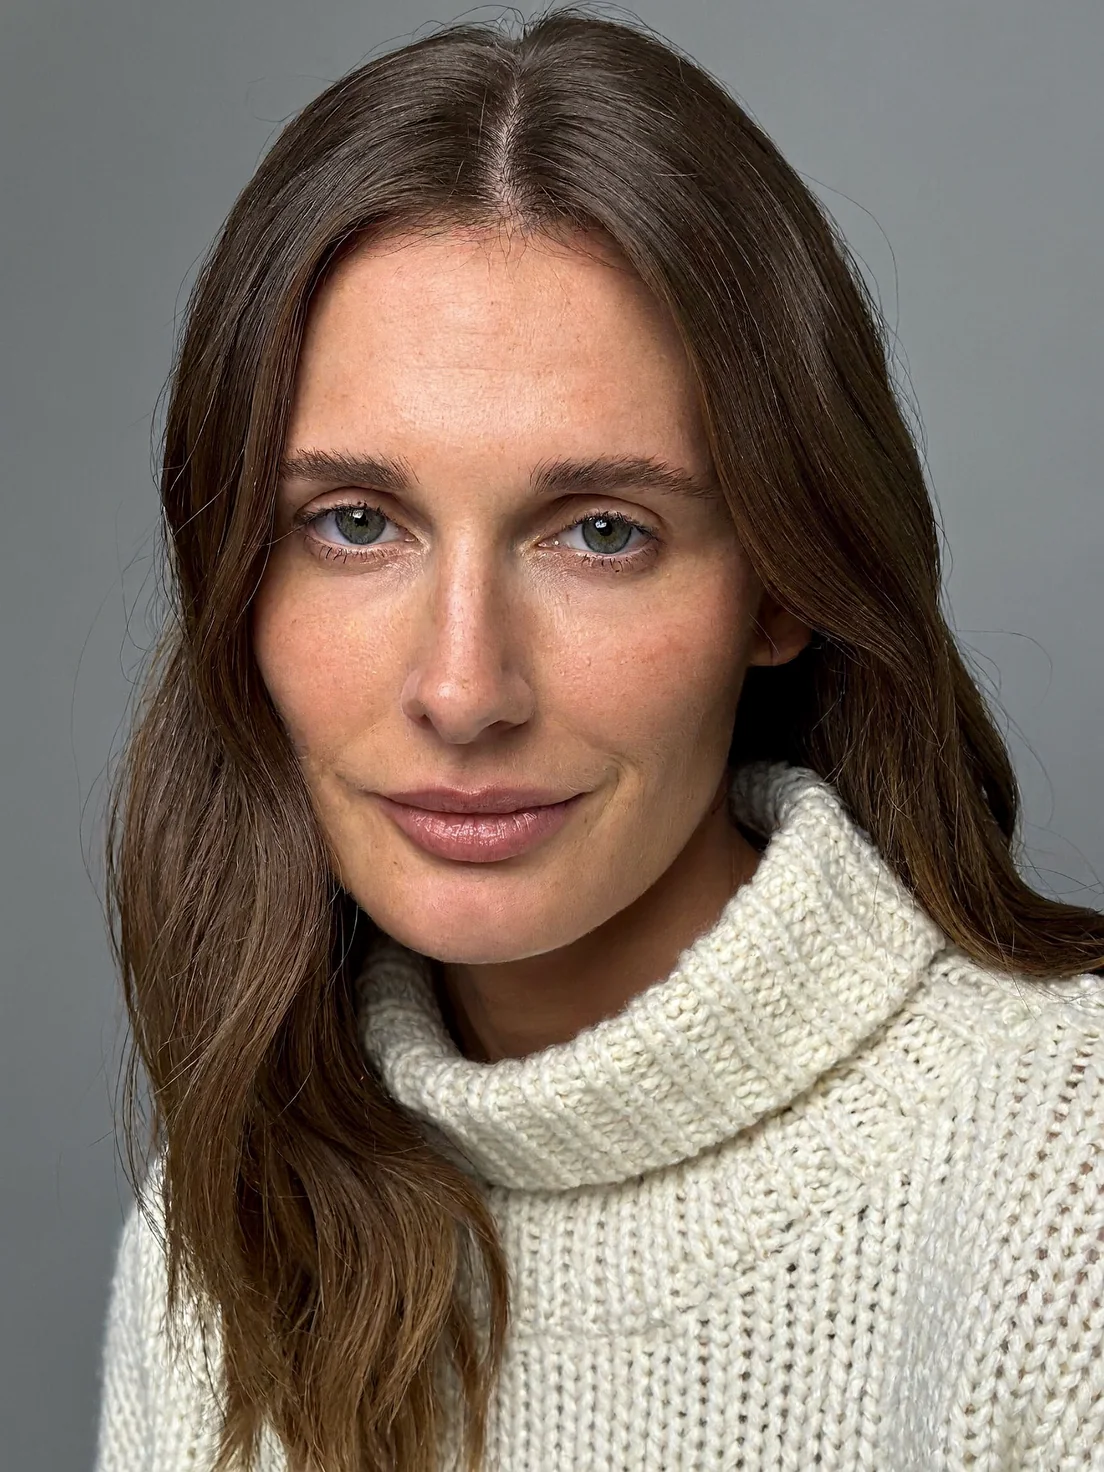
Первая фраза дала худое лицо, которое выглядит старше. Вторая — более полное и спокойное. Слова «впалые щёки» в обучающих подписях чаще стояли рядом с измождёнными и немолодыми лицами, и модель тянет за ними всё остальное. Похожее у нас было с кожей: после слов «поры, предельная резкость» кожа выходила шершавой.
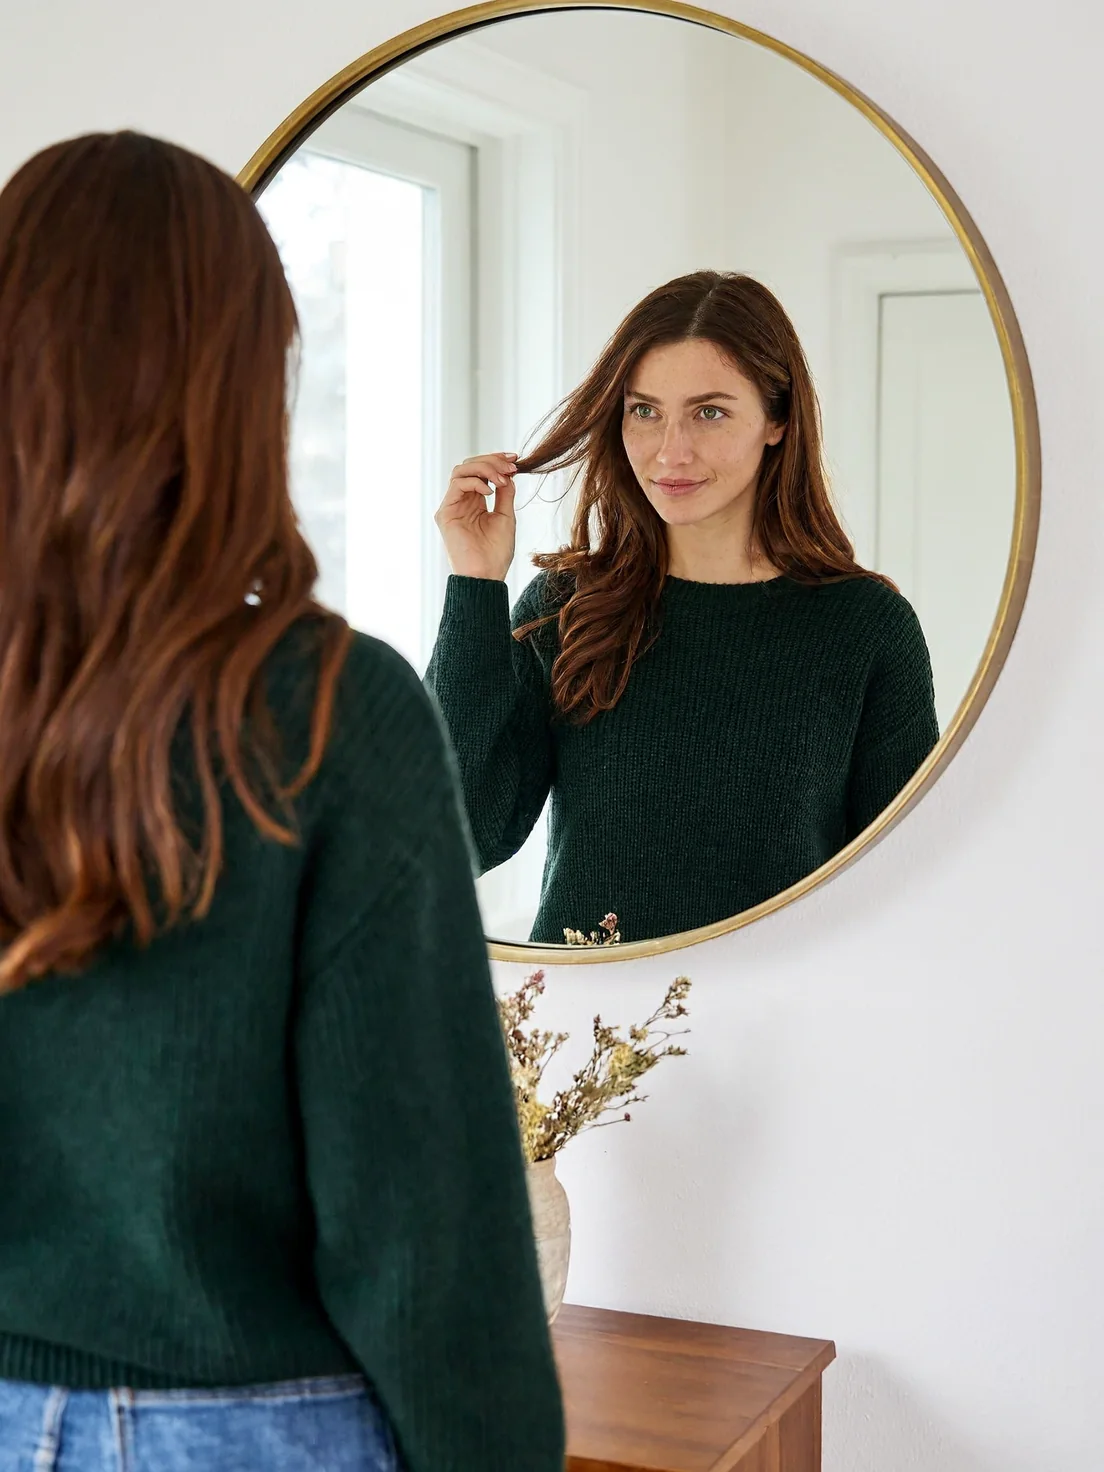
Женщина стоит у зеркала с опущенной рукой. Её отражение поднимает руку к волосам и смотрит в камеру. Волосы у женщины рыжеватые, у отражения — тёмно-каштановые. Модель не вычисляет отражение. Она рисует «женщину у зеркала» и «лицо в зеркале» как два правдоподобных куска картинки и не сверяет их между собой.
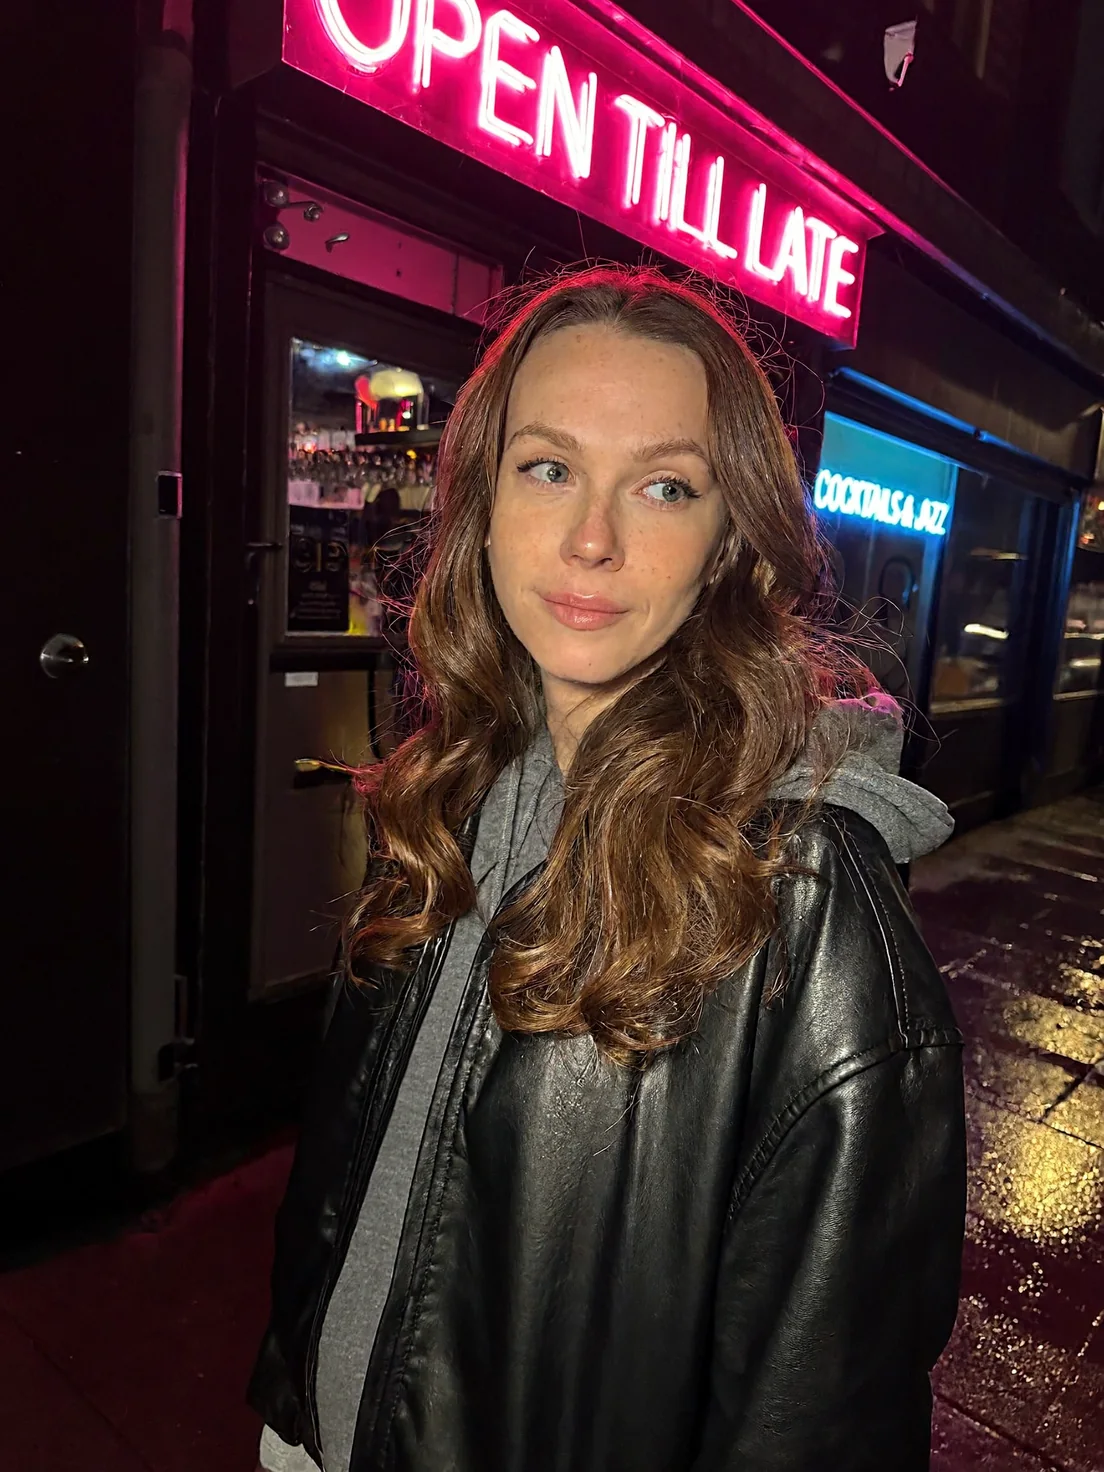
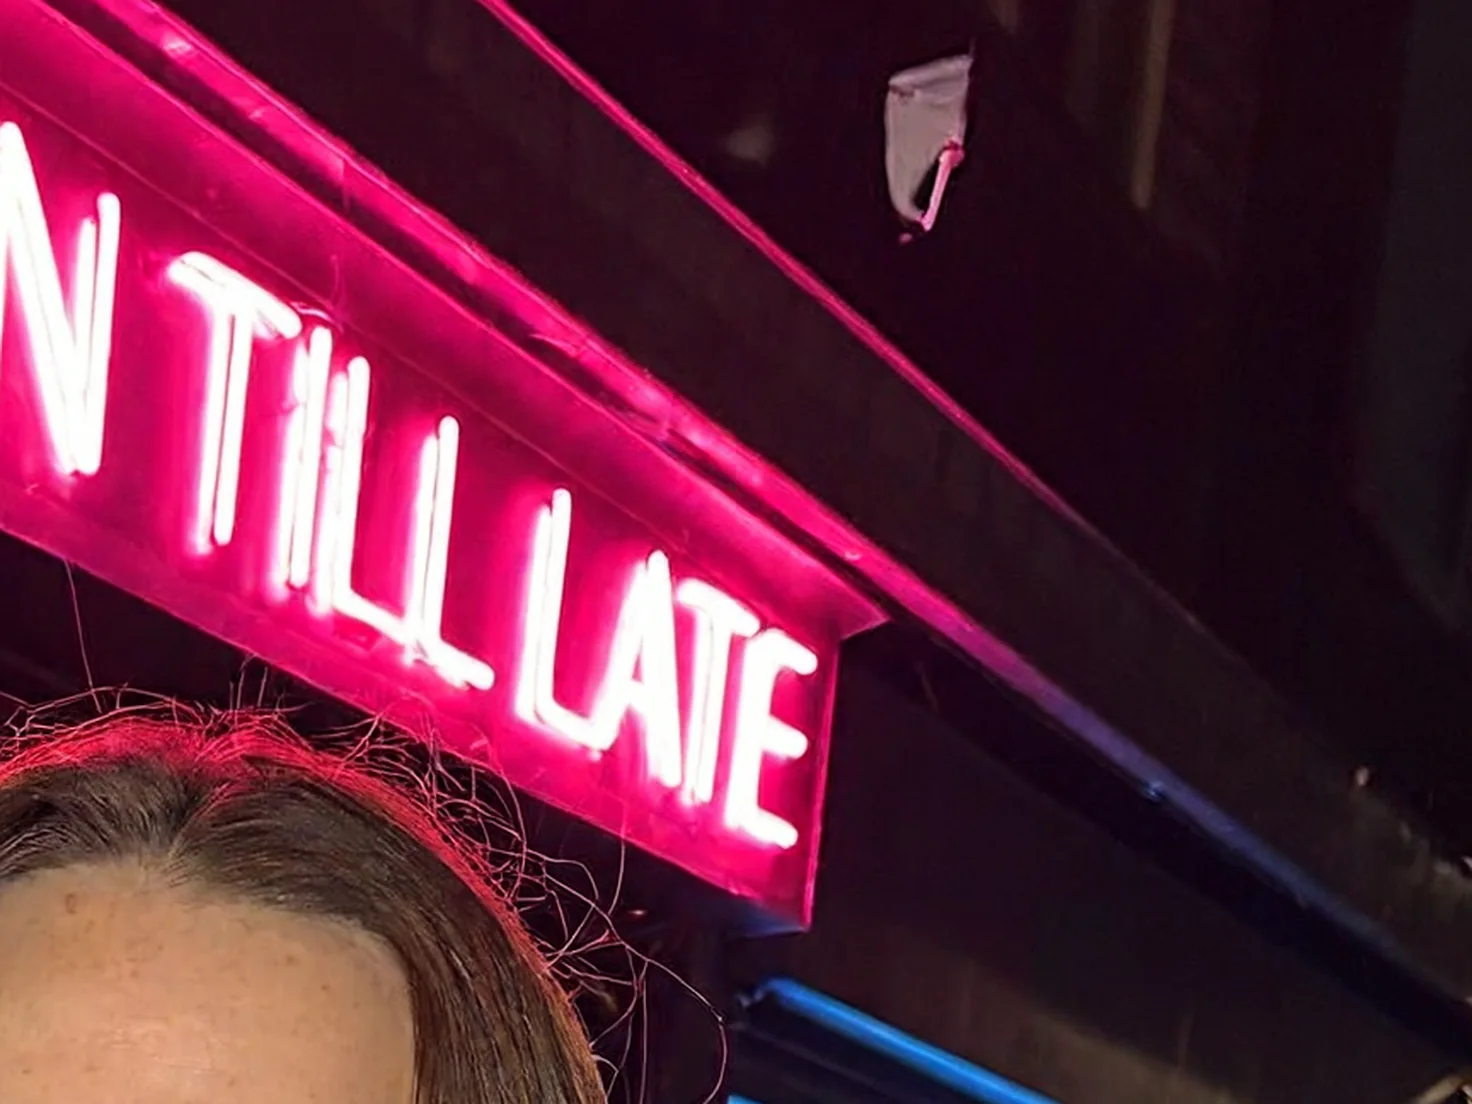
Большую вывеску OPEN TILL LATE модель написала без ошибок. Маленькая синяя должна была читаться как COCKTAILS, а после этого слова на ней каша из букв. На большую надпись приходится много ячеек сетки, и форма каждой буквы получается. На маленькую ячеек не хватает. Меловая доска из раздела выше получилась у всех трёх моделей по той же причине: текст там занимает половину кадра.
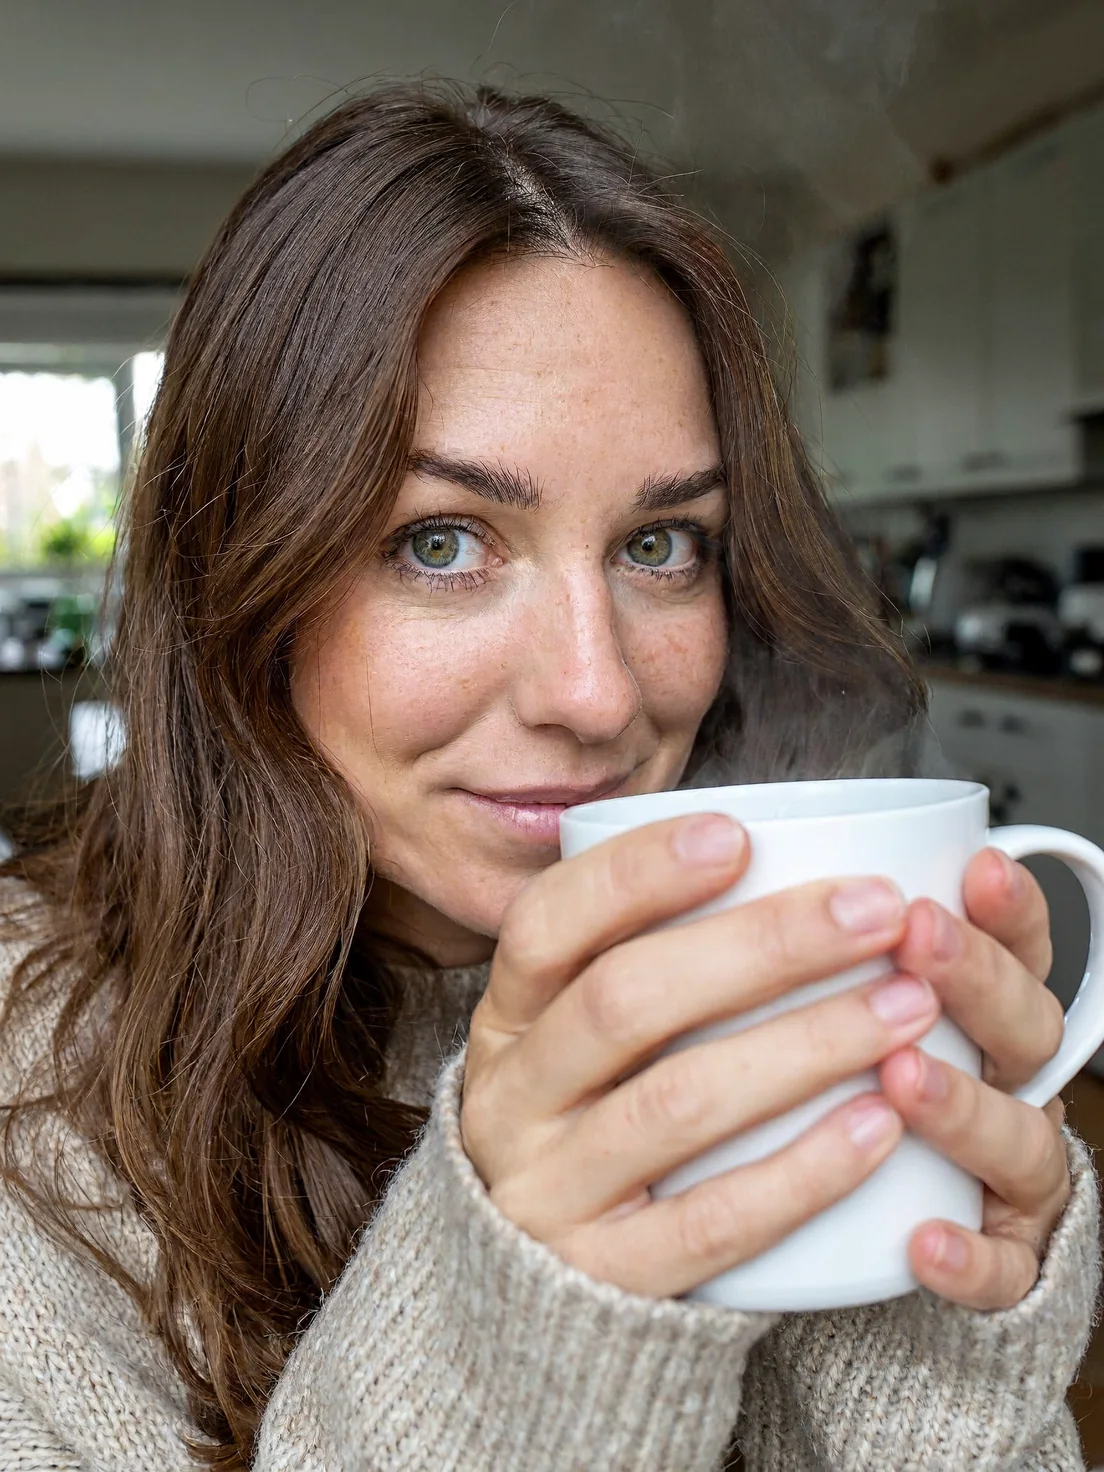
Руки считаются слабым местом нейросетей. В этом кадре они получились правдоподобно, пальцев столько, сколько нужно. Это один кадр, и по нему мы не судим о руках вообще: руки мы проверяем на каждой картинке отдельно.
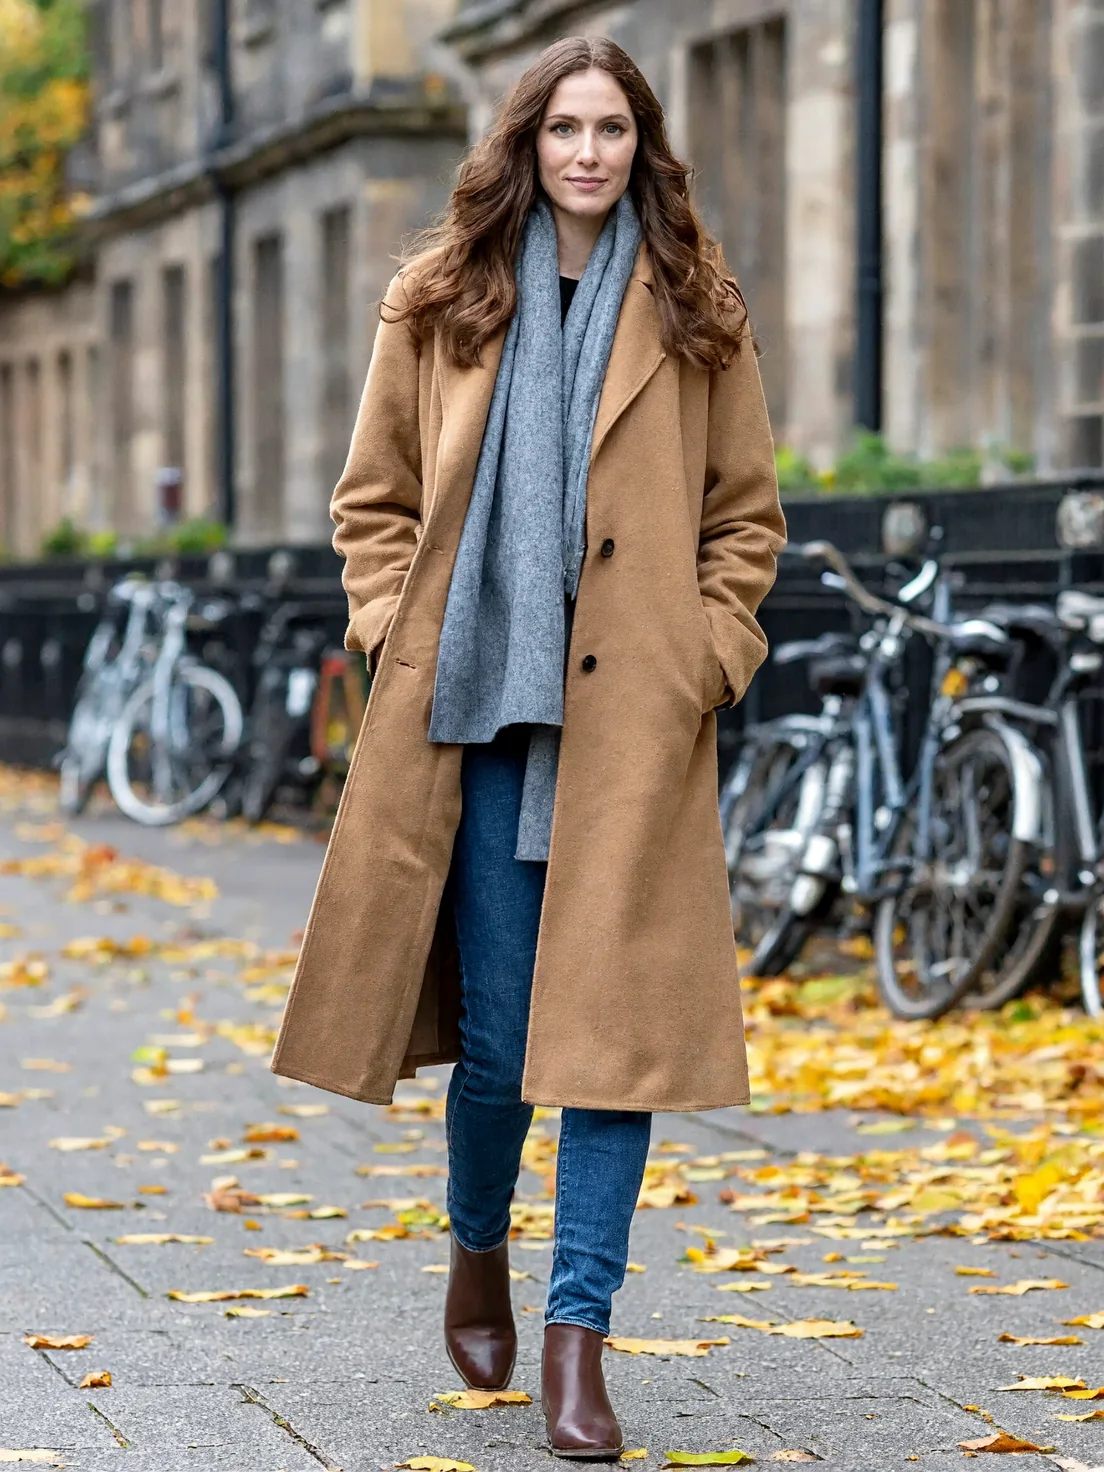
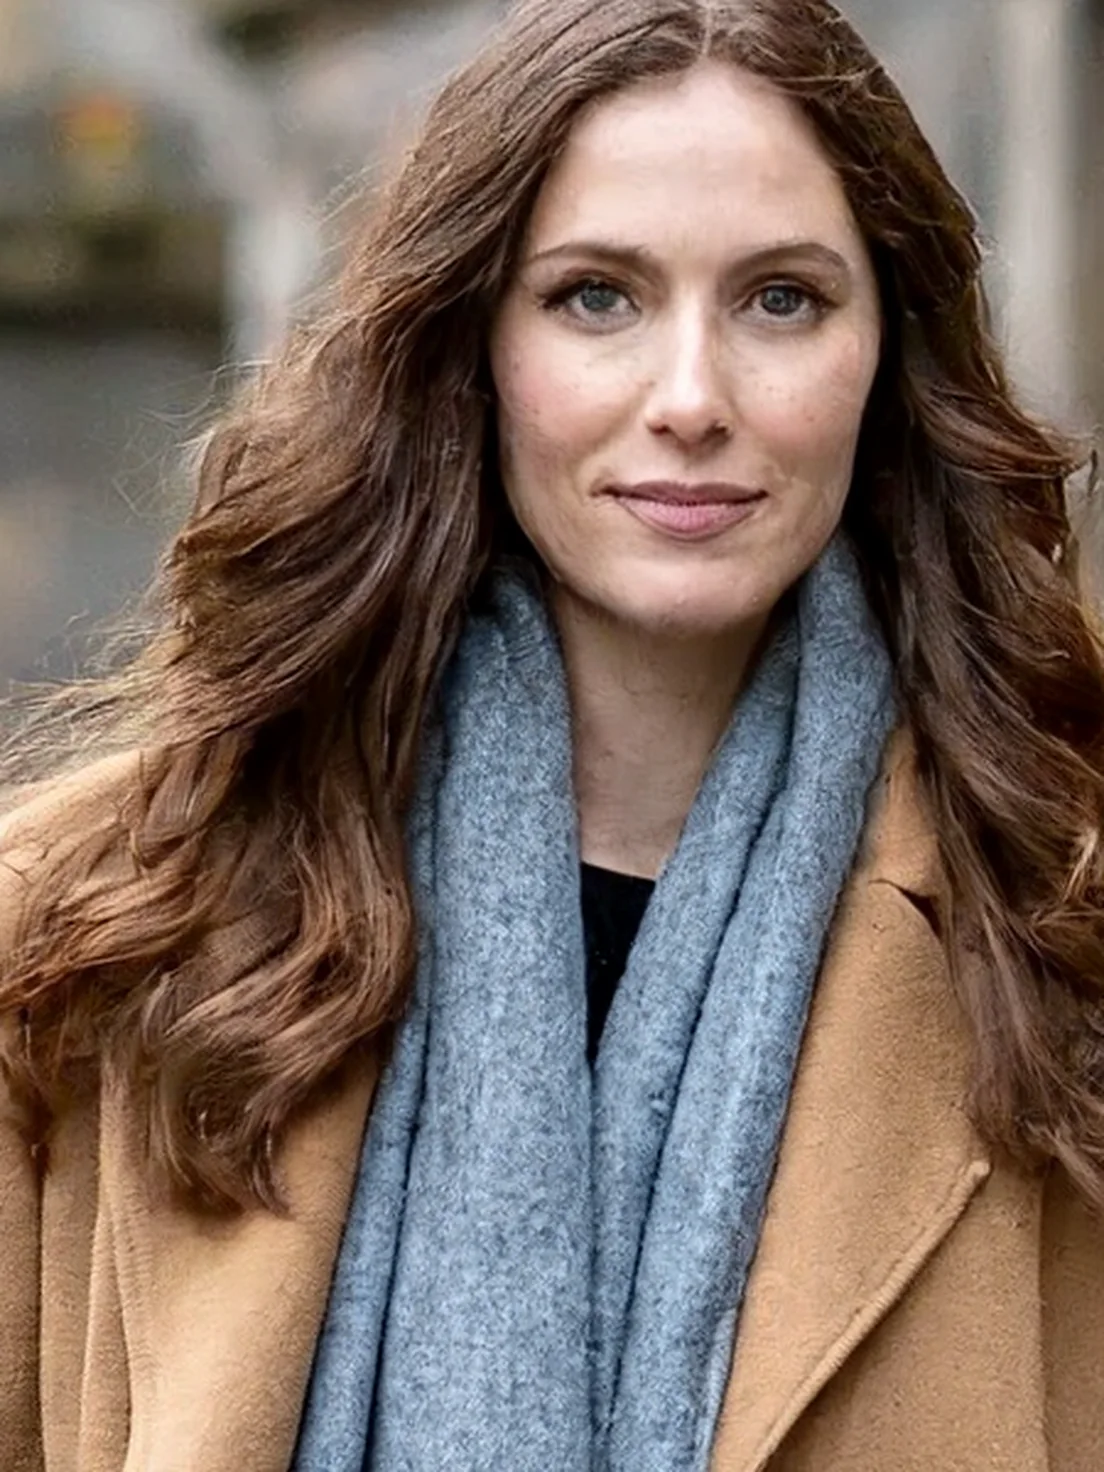
В кадре в полный рост лицо занимает около 250 пикселей в ширину. Здесь оно получилось мягким, но без брака. По нашим записям, так везёт не всегда: на лицах около 240 пикселей глаза часто выходят смазанными, а на крупных планах, где лицо шире 600 пикселей, такого нет. Причина та же, что с маленькой вывеской: на лицо приходится слишком мало ячеек. Если нужен человек в полный рост с чётким лицом, мы рисуем картинку крупнее.
Раз модель не помнит лиц, ей нужно показать образец. H3-Image принимает картинки вместе с запросом. Мы приложили студийный портрет и попросили ту же женщину в кафе и на улице.
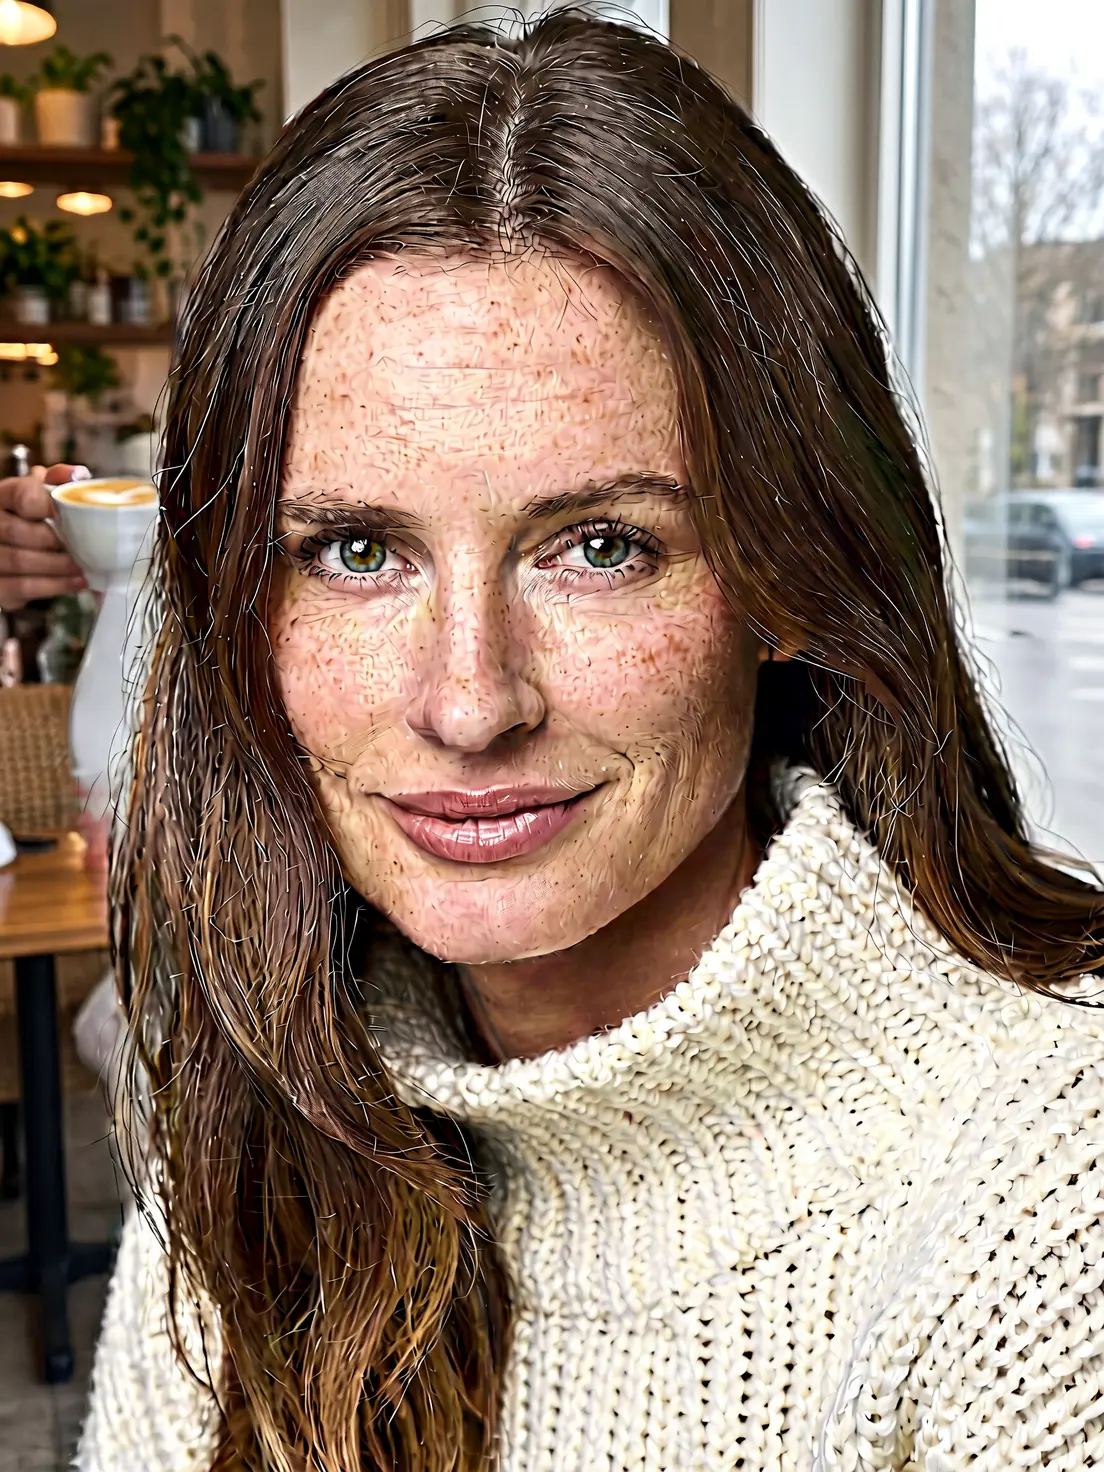
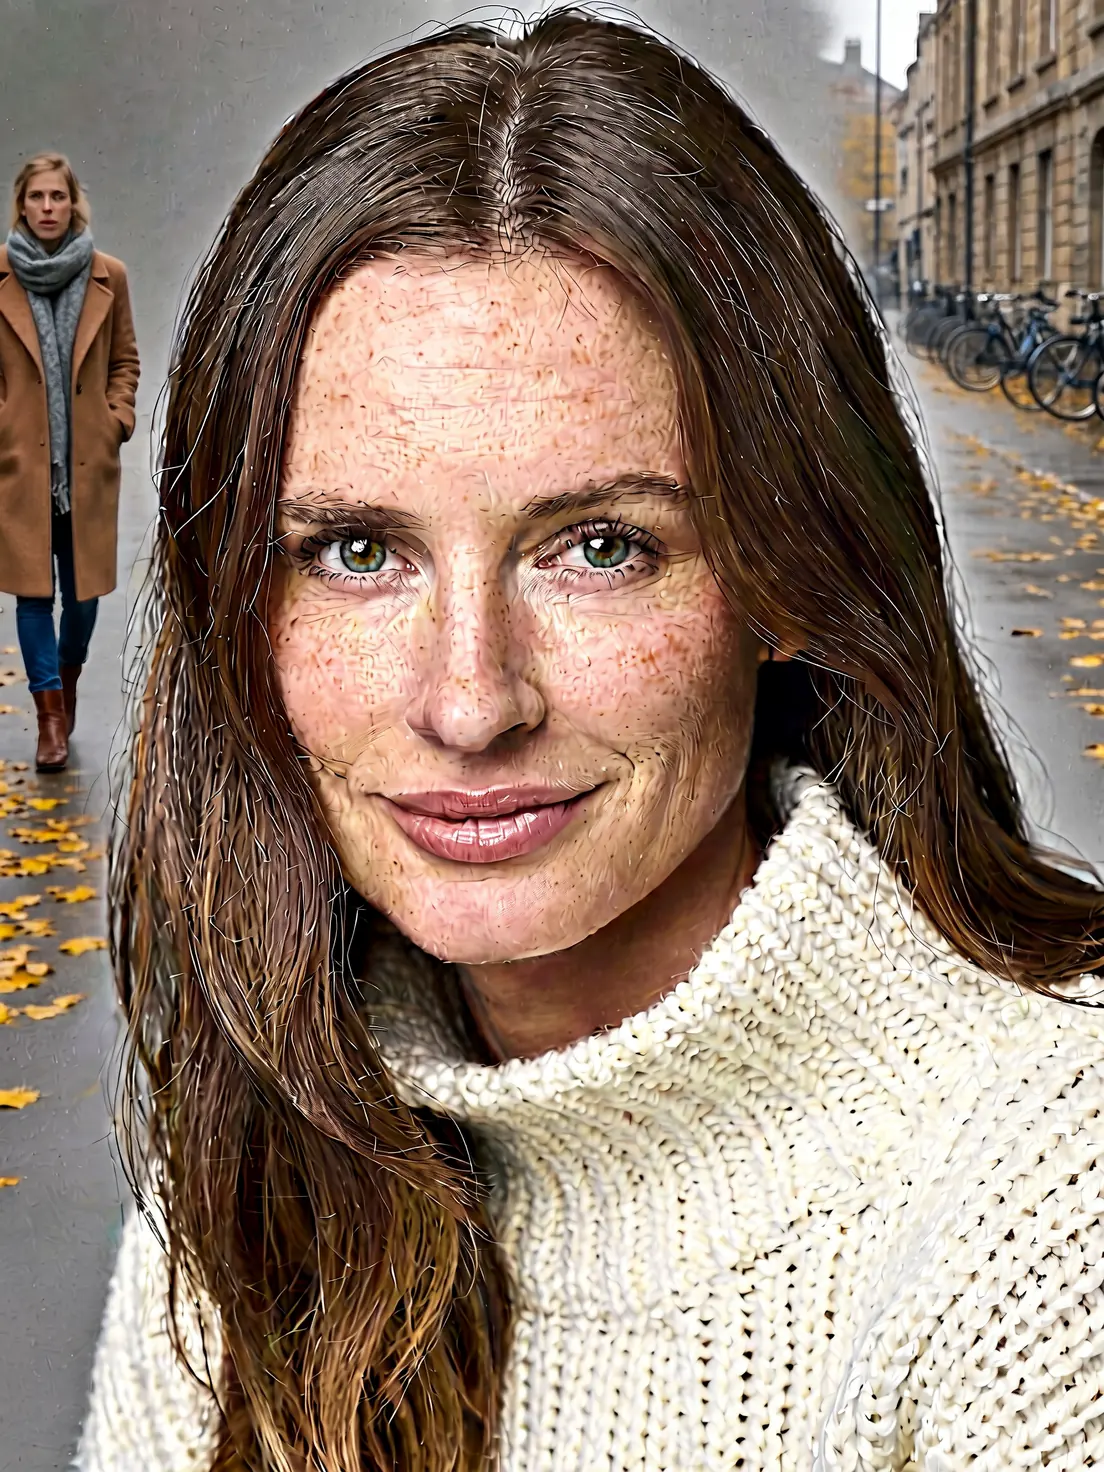
Вышел брак. Модель не нарисовала женщину заново: она вставила исходный портрет, огромный и перешарпленный, поверх новой сцены. На заднем плане появилась вторая маленькая фигура.
Сначала мы меняли слова. Убрали из запроса «точно» и «новая фотография из той же съёмки». Потом прямо написали: не вставляй и не копируй образец. Не помогло ни то, ни другое.
Помогло изменить сам образец. Портрет был снят вплотную, голова и плечи занимали весь кадр. Мы уменьшили его вдвое и положили на холст того же цвета, что его фон.
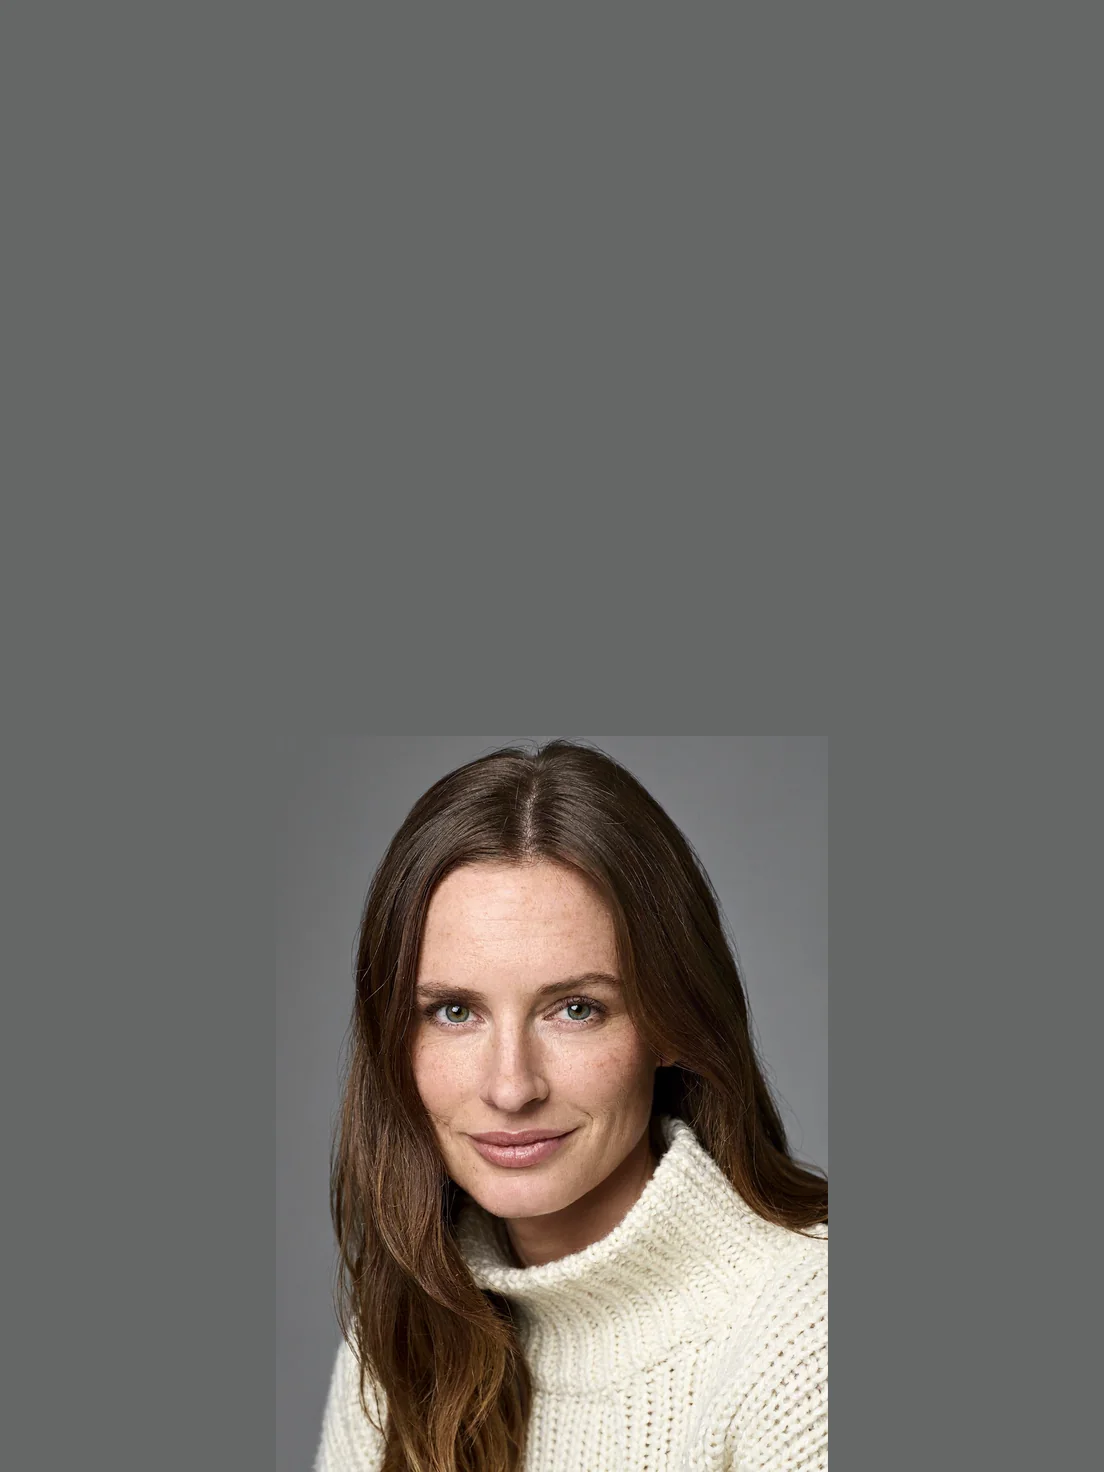
С таким образцом модель нарисовала новые сцены, и женщина в них узнаётся.
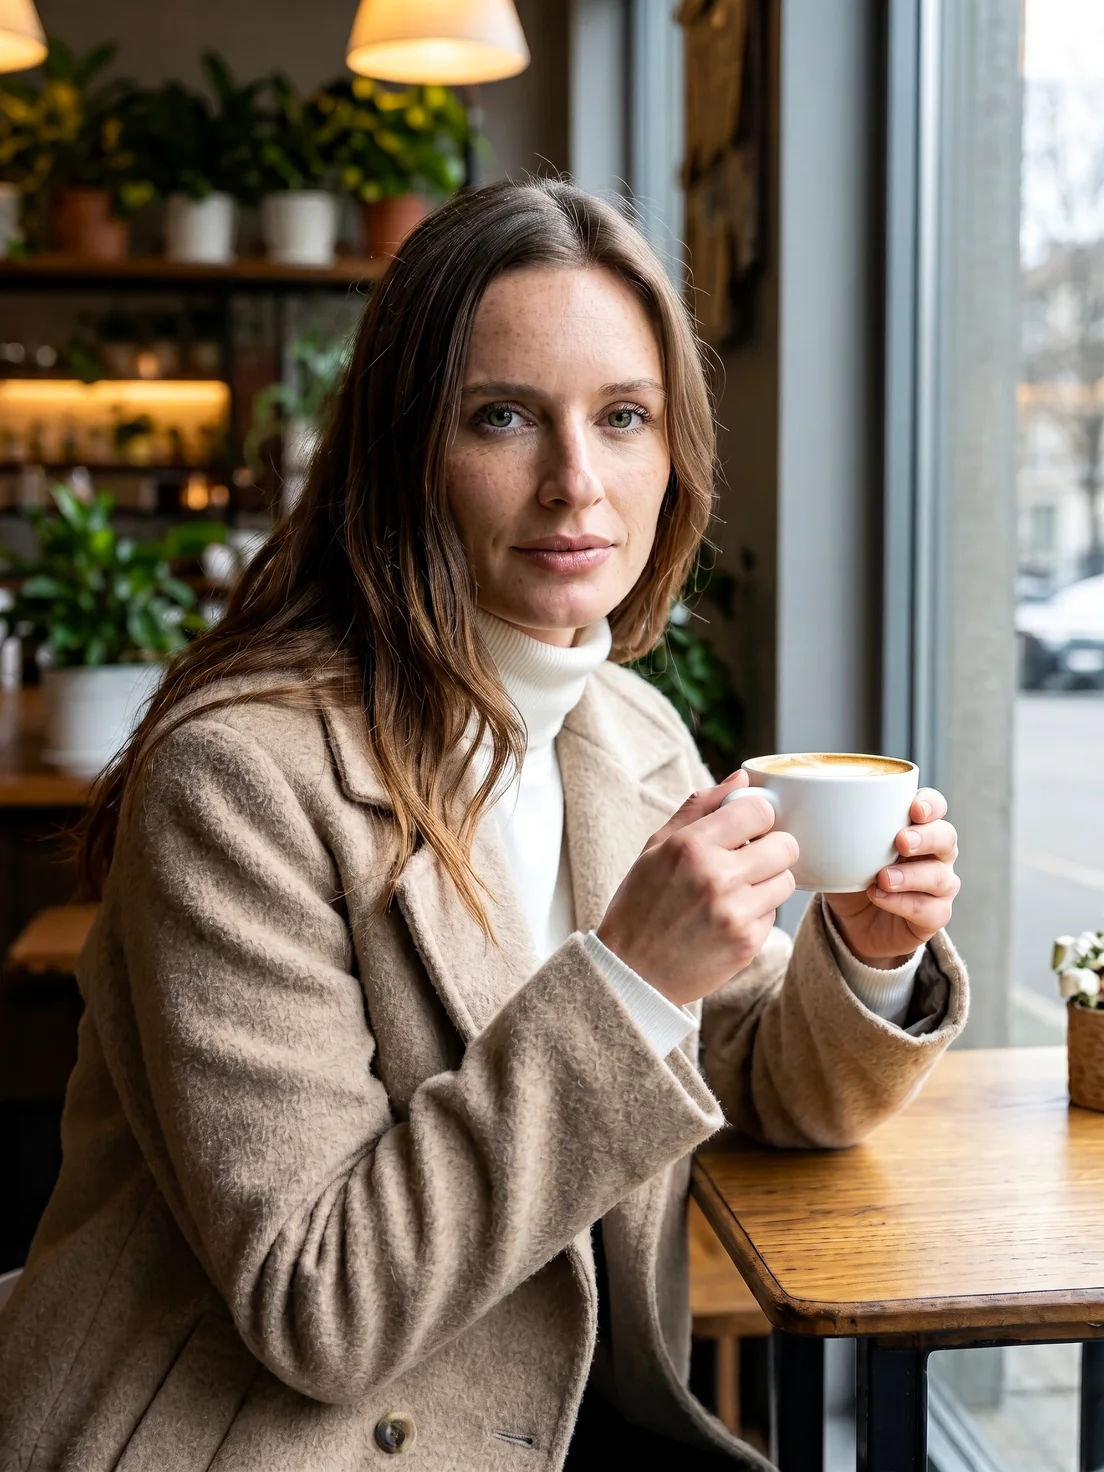
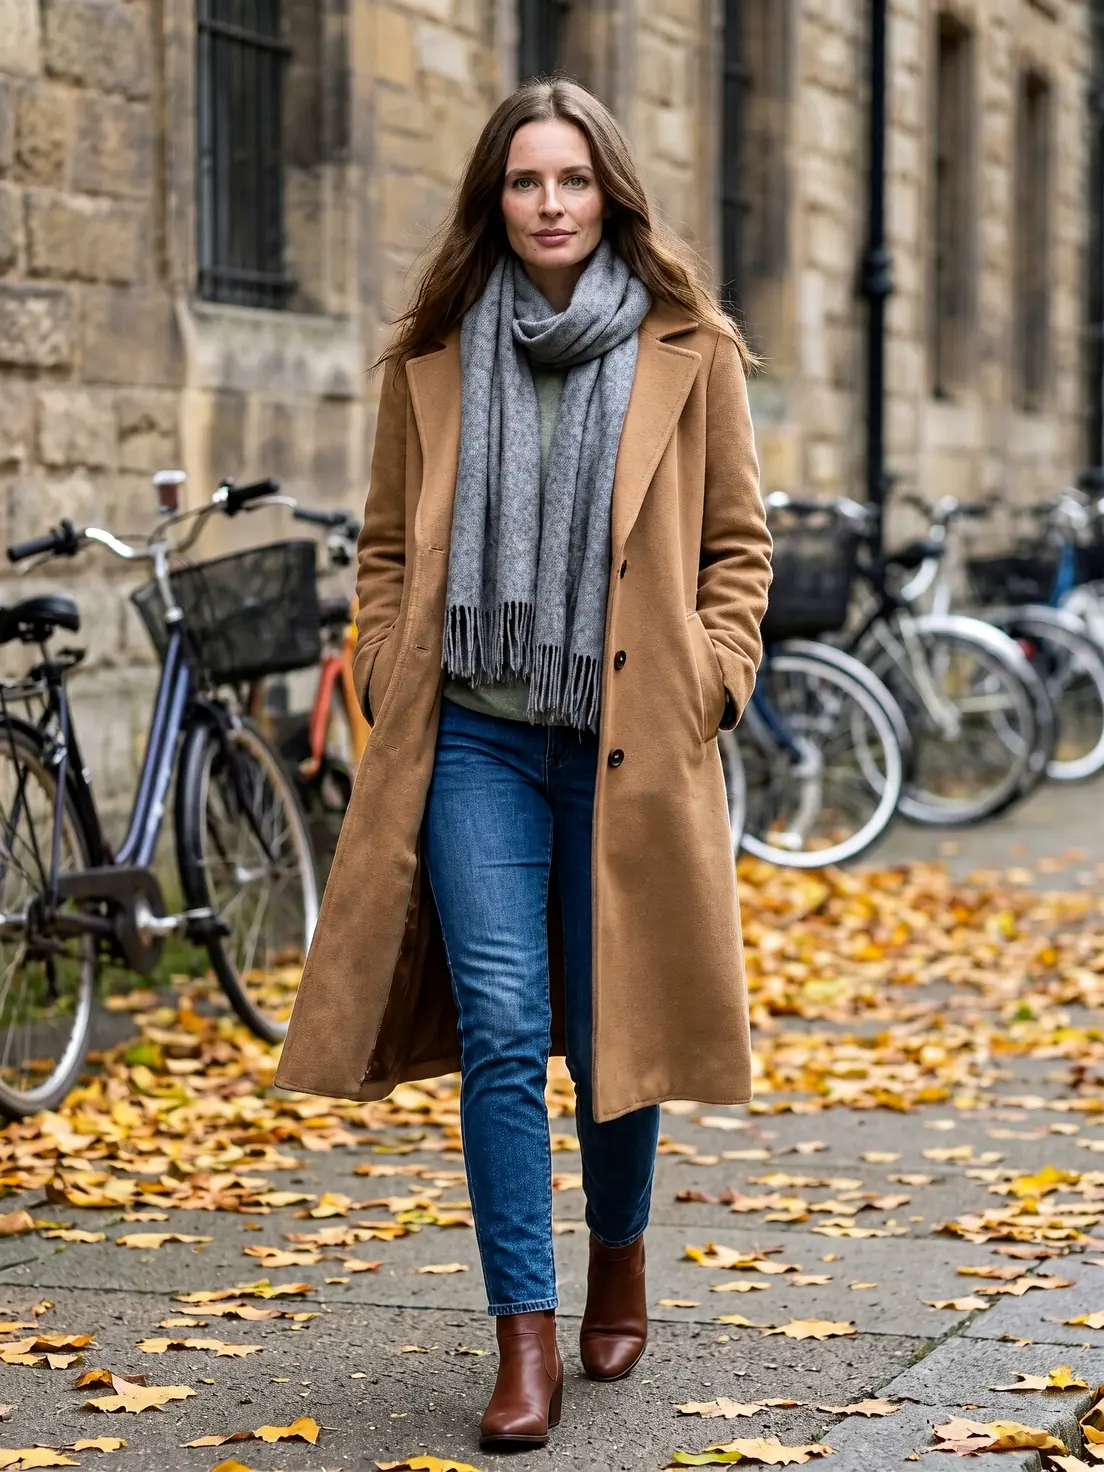
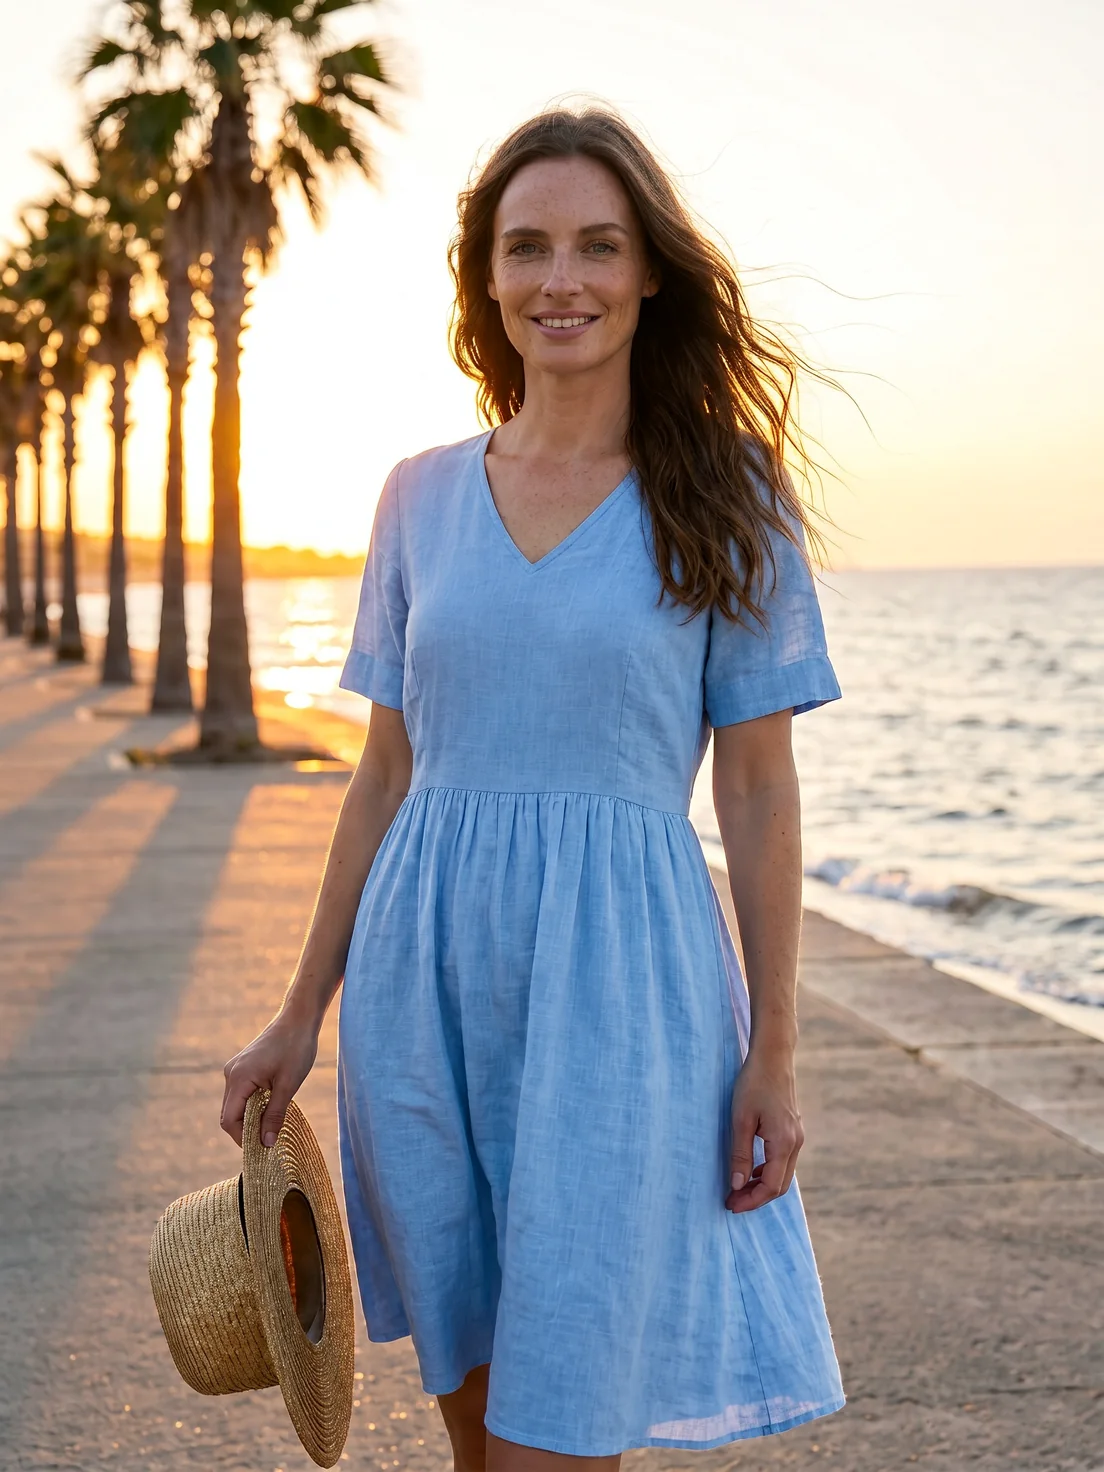
Запрос слушается не до конца: у моря мы просили кадр по колено, а получили почти в полный рост.
Почему первый образец ломал картинку, мы точно не знаем. Наше предположение: когда лицо занимает весь образец, модели проще перенести его целиком, чем нарисовать заново в другом масштабе.
У нас был и другой случай с образцами. На кадрах в полный рост модель рисовала глаза не того цвета, пока образцом служила картинка с маленьким лицом. Мы добавили вторым образцом крупный план лица, и цвет стал верным.
Мы оставили тот же образец с длинными каштановыми волосами, а в тексте попросили короткое платиновое каре.
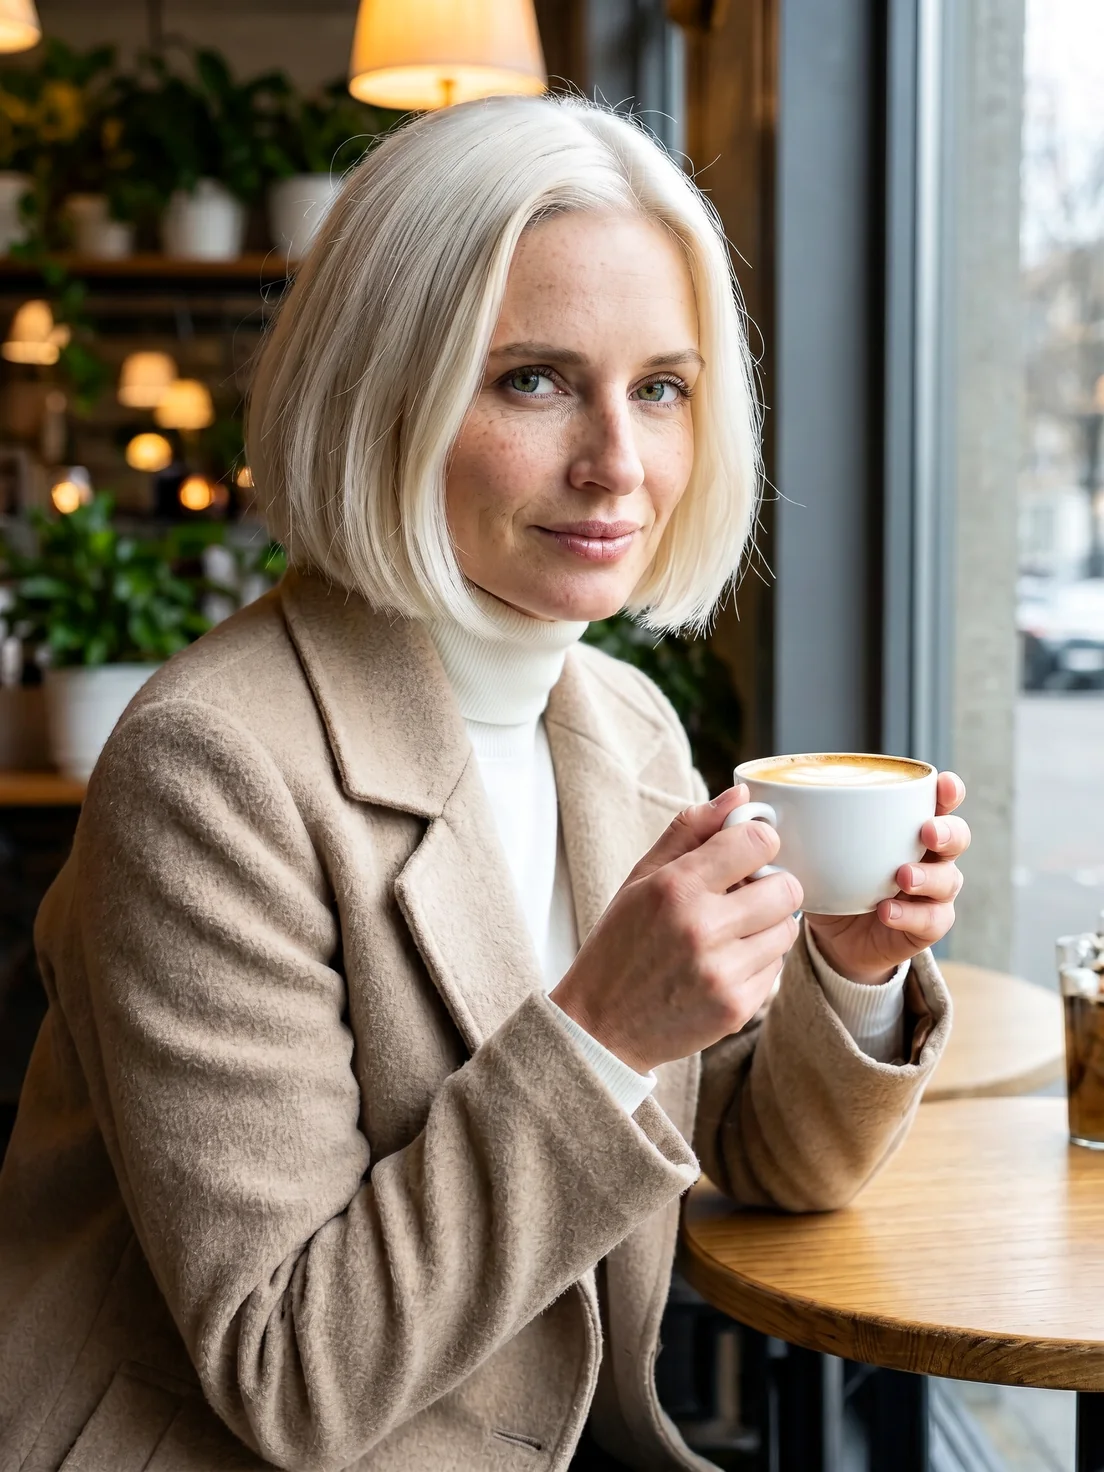
Волосы получились по тексту. Сцена нормальная, но лицо стало старше и на образец похоже меньше. Если текст и образец противоречат друг другу, страдает сходство.
Версия библиотеки для видеокарты. H3-Image в сжатом формате на старой сборке PyTorch (CUDA 12.8) роняла программу: Python вылетал с ошибкой доступа к памяти, а задания, которые стояли в очереди, пропадали. На новой сборке (CUDA 13.0) вылеты прекратились, и та же задача стала считаться за 22 секунды вместо 58. Мы проверили это контрольным запуском, где менялась только сборка. ComfyUI при старте сам предупреждает, что CUDA ниже 13.0 устарела, — мы это предупреждение сначала пропустили.
Причину вылета пришлось искать в журнале Windows. Наша тестовая копия ComfyUI не писала свой вывод в файл, и после вылета от неё ничего не оставалось. Запись о сбое нашлась в журнале приложений Windows: там указан модуль, в котором программа упала.
Вылет без причины. Один раз программа упала на первом же задании для Qwen-Image-Edit, в библиотеке NVIDIA. После перезапуска то же задание прошло. Причину мы не нашли.
Кодировка консоли. Мы запускали ComfyUI на Windows удалённо, без окна консоли. В таком запуске вывод программы идёт в старой западноевропейской кодировке. Полоска прогресса содержит символы, которых в этой кодировке нет, и генерация падала с ошибкой прямо посреди шагов. Лечится двумя переменными окружения: PYTHONIOENCODING=utf-8 и PYTHONUTF8=1.
Помощник для запросов. H3-Image нужны длинные подробные запросы, и авторы предлагают писать их с помощью языковой модели. У нас этот помощник тратил от 216 до 301 секунды на одну картинку и иногда молча не укладывался в отведённое время. На такие тихие сбои мы потеряли три часа. Теперь длинные запросы пишем сами.
Очередь к видеокарте. Видеокартой у нас пользуются несколько программ, и перед работой каждая берёт её в очередь, а после — отдаёт. Мы остановили программу, которая в этот момент держала видеокарту. Отметка «занято» осталась висеть, и остальные ждали впустую. Теперь такие программы мы не останавливаем, а ждём, пока они закончат.
Файл в 0 байт. Пока файл модели качается, Windows показывает его размер как 0 байт. Это не значит, что загрузка сломалась.
Оценка по уменьшенной картинке. Иконку нужно смотреть в том размере, в каком её увидит человек, — у нас это 40 пикселей. Обратная ошибка тоже была: исходную картинку мы рассматривали в мелком виде и приняли забрало шлема за лобовое стекло.
Точные тексты запросов ко всем картинкам лежат в файле prompts.json.
Собственный материал редакции: проверяли сами, на своём компьютере. Нашли ошибку?
· 1 мин чтения
· 1 мин чтения
· 1 мин чтения